Deep Residual Learning for Image Recognition
Giải Best Paper chính thức · NguồnCác kết nối tắt giúp mạng học phần thay đổi so với đầu vào, hỗ trợ tối ưu hóa mạng sâu.

BÀI BÁO HỘI NGHỊ
Đọc các công trình AI có nguồn xác minh, duyệt theo hội nghị, năm và ghi nhận. Giải thưởng chính thức có dẫn nguồn; EyeCode Pick là tuyển chọn biên tập riêng.
DANH MỤC HỘI NGHỊ
THƯ VIỆN BÀI BÁO
Các kết nối tắt giúp mạng học phần thay đổi so với đầu vào, hỗ trợ tối ưu hóa mạng sâu.
Transformer dùng attention để mô hình hóa chuỗi mà không cần mạng hồi quy hoặc tích chập.
Tách ước lượng chuyển động nhanh và lập bản đồ chậm hơn để kết hợp dữ liệu LiDAR trong thời gian thực.
Nghiên cứu đếm các đối tượng khó phân biệt trong cảnh dưới nước và giới thiệu bộ dữ liệu IOCfish5K.
Bài báo nghiên cứu mức độ cô đọng của Transformer khi biểu diễn ngôn ngữ hình thức. Các chứng minh so sánh kích thước biểu diễn với automata và logic thời gian, đồng thời chỉ ra độ khó của việc kiểm chứng mô hình.
Nghiên cứu kiểm tra vì sao mô hình ngôn ngữ gặp khó khăn khi yêu cầu được cung cấp qua nhiều lượt hội thoại. Phương pháp mô phỏng tách năng lực giải bài toán khỏi độ tin cậy và phân tích ảnh hưởng của những giả định hình thành quá sớm.
Polar Express giải bài toán phân rã cực của ma trận trong bộ tối ưu Muon. Phương pháp chọn đa thức qua bài toán minimax, sử dụng phép nhân ma trận phù hợp GPU và phân tích sai số trong tính toán độ chính xác hữu hạn.
Bài báo phân tích hiện tượng căn chỉnh an toàn chỉ tập trung vào vài token đầu của câu trả lời. Các thí nghiệm và mục tiêu fine-tuning có điều chuẩn khảo sát cách kéo dài hành vi an toàn và hạn chế sự suy giảm sau fine-tuning.
Nghiên cứu phân rã từng bước thay đổi dự đoán trong quá trình fine-tuning mô hình ngôn ngữ. Khung phân tích liên hệ ảnh hưởng giữa các câu trả lời với hiện tượng lặp, hallucination và sự suy giảm xác suất của đáp án mong muốn trong DPO.
AlphaEdit cập nhật kiến thức trong mô hình ngôn ngữ mà hạn chế tác động lên kiến thức cần giữ lại. Phương pháp chiếu thay đổi tham số vào không gian null của biểu diễn kiến thức được bảo toàn, kèm phân tích và thí nghiệm chỉnh sửa tuần tự.
In-Run Data Shapley đánh giá đóng góp của dữ liệu đối với một lần huấn luyện cụ thể. Phương pháp tích lũy giá trị Shapley của các bước cập nhật gradient, tránh phải huấn luyện lại mô hình trên nhiều tập con dữ liệu.
SAM 2 mở rộng phân đoạn theo prompt từ ảnh sang video. Kiến trúc Transformer với bộ nhớ dạng streaming kết hợp quy trình thu thập dữ liệu có tương tác, giúp theo dõi vùng được chỉ định qua các khung hình.
Nghiên cứu kết hợp cơ chế chuyển yêu cầu giữa mô hình nhỏ và lớn với speculative decoding. Quy tắc chuyển mô hình được thực thi qua suy đoán và kiểm tra song song, nhằm khảo sát đánh đổi giữa chi phí suy luận và chất lượng câu trả lời.
Infinity-Chat cung cấp các yêu cầu mở cùng đánh giá của con người để nghiên cứu sự đa dạng trong câu trả lời. Bài báo phân tích mức lặp bên trong một mô hình, sự tương đồng giữa các mô hình và khác biệt trong sở thích của người đánh giá.
Nghiên cứu khảo sát vai trò của gating trong softmax attention. Một cổng sigmoid theo từng head được đặt sau scaled dot-product attention để phân tích tính phi tuyến, độ thưa, độ ổn định huấn luyện và hiện tượng attention sink.
Bài báo khảo sát việc tăng độ sâu mạng trong học tăng cường tự giám sát theo mục tiêu. Các thí nghiệm locomotion và manipulation phân tích cách kiến trúc sâu, kết nối residual và quy mô huấn luyện ảnh hưởng đến hành vi đạt mục tiêu.
Nghiên cứu phân biệt thời điểm mô hình diffusion bắt đầu sinh mẫu hữu ích và thời điểm ghi nhớ dữ liệu huấn luyện. Thí nghiệm cùng mô hình random features phân tích cách động lực học tối ưu tạo ra một khoảng huấn luyện có khả năng khái quát hóa.
Nghiên cứu so sánh mô hình nền và mô hình huấn luyện bằng phần thưởng kiểm chứng được trên các bài toán suy luận. Đánh giá pass@k và phân tích phân phối lời giải giúp phân biệt lấy mẫu hiệu quả hơn với việc xuất hiện kiểu suy luận mới.
Bài báo nghiên cứu lợi ích của việc biết trước chuỗi đầu vào chưa gán nhãn trong học trực tuyến. Các cận trên và cận dưới liên hệ số lỗi với chiều Littlestone, làm rõ khác biệt giữa thiết lập transductive và trực tuyến thông thường.
Nghiên cứu dùng mô hình đơn giản với các đặc trưng chồng lấp để giải thích quy luật scaling. Phân tích hình học và thí nghiệm mô hình ngôn ngữ khảo sát quan hệ giữa chiều biểu diễn, mức superposition và sai số.
VAR mô hình hóa việc sinh ảnh như dự đoán biểu diễn ở độ phân giải tiếp theo. Cách sinh từ thô đến tinh thay thế thứ tự quét từng token, đồng thời cho phép nghiên cứu scaling và các tác vụ chỉnh sửa ảnh.
STDE xử lý chi phí tính các toán tử vi phân bậc cao trong mạng neural. Phương pháp kết hợp Taylor-mode automatic differentiation với ngẫu nhiên hóa phép co tensor để ước lượng toán tử, phục vụ các bài toán như physics-informed neural networks.
Rho-1 đặt câu hỏi liệu mọi token có đóng góp như nhau khi pretraining. Selective Language Modeling dùng mô hình tham chiếu chấm điểm token và tập trung hàm mất mát vào những token phù hợp với phân phối mục tiêu.
Bài báo nghiên cứu cách điều khiển chất lượng ảnh mà không gắn chặt với mức đa dạng. Autoguidance dùng một phiên bản nhỏ hơn hoặc huấn luyện ít hơn của cùng mô hình diffusion để hướng dẫn quá trình sinh mẫu.
PRISM liên kết bối cảnh nhân khẩu học và sở thích tự khai báo với phản hồi trong hội thoại giữa người dùng và mô hình ngôn ngữ. Bộ dữ liệu hỗ trợ phân tích tính đại diện, khác biệt văn hóa và sự bất đồng trong dữ liệu căn chỉnh.
Bài báo xem lại conformal prediction từ góc nhìn Bayesian để đánh giá rủi ro khi triển khai mô hình. Bayesian quadrature được dùng để biểu diễn phân phối tổn thất có thể gặp, thay vì chỉ dựa vào bảo đảm tần suất.
Nghiên cứu xây dựng các tác vụ thuật toán nhỏ để kiểm tra khả năng lập kế hoạch và sinh kết quả đa dạng. So sánh dự đoán một token với phương pháp nhiều token và nhiễu đầu vào tạo một môi trường kiểm nghiệm có kiểm soát cho tính sáng tạo.
CollabLLM huấn luyện mô hình cho mục tiêu hợp tác qua nhiều lượt thay vì chỉ câu trả lời kế tiếp. Mô phỏng hội thoại ước lượng phần thưởng dài hạn để mô hình chủ động làm rõ ý định và hỗ trợ người dùng hoàn thành công việc.
Nghiên cứu mở rộng score matching cho dữ liệu thiếu ở những tập tọa độ khác nhau. Hai hướng importance weighting và variational estimation được phân tích để học phân phối mà không cần quan sát đầy đủ mọi biến.
Bài báo phân tích đánh đổi giữa bài toán infilling khi huấn luyện và khả năng chọn thứ tự token khi suy luận của masked diffusion. Các kết quả lý thuyết và thực nghiệm khảo sát cách thứ tự giải mã thích ứng tránh những bài toán con khó.
Nghiên cứu đánh giá vai trò của dự đoán khi chính sách cần ưu tiên những người gặp khó khăn nhất. Mô hình toán học và trường hợp thất nghiệp dài hạn so sánh cải thiện dự đoán với mở rộng năng lực cung cấp hỗ trợ.
Nghiên cứu kiểm tra giả định rằng sinh token theo thứ tự tùy ý luôn hỗ trợ suy luận trong diffusion language models. JustGRPO dùng thứ tự trái sang phải trong RL rollouts để khảo sát việc né token không chắc chắn, đồng thời giữ giải mã song song khi suy luận.
Bài báo xây dựng thuật toán lấy mẫu dựa trên truy vấn score hoặc gradient cho diffusion và phân phối log-concave. Phân tích độ phức tạp làm rõ quan hệ giữa độ chính xác đích, sai số score và các giả định về dữ liệu.
Nghiên cứu kiểm tra mô hình lập trình được huấn luyện cùng bộ phát hiện hành vi đánh lừa. Khung phân loại tách thay đổi biểu diễn khỏi cách diễn đạt né bộ phát hiện, đồng thời khảo sát tác động của điều chuẩn KL và mức phạt.
Motive nghiên cứu những clip huấn luyện nào ảnh hưởng đến chuyển động trong video được sinh. Phương pháp attribution dựa trên gradient dùng mặt nạ theo chuyển động để tách động lực thời gian khỏi vẻ ngoài tĩnh và hỗ trợ chọn dữ liệu fine-tuning.
Bài báo tách ghi nhớ dữ liệu cụ thể khỏi khái quát hóa về quá trình sinh dữ liệu. Một phép đo dựa trên thông tin và các thí nghiệm dung lượng mô hình khảo sát quan hệ giữa kích thước dữ liệu, ghi nhớ và membership inference.
Nghiên cứu lý giải vì sao các mô hình diffusion học từ tập con khác nhau có thể sinh kết quả tương tự với cùng noise seed. Khung random matrix phân tích thống kê Gaussian chung và biến thiên do dữ liệu hữu hạn, làm cơ sở so sánh với mô hình phi tuyến.
Bài báo chứng minh hiện tượng khái quát hóa xuất hiện muộn trong ridge regression. Phân tích gradient descent với weight decay liên hệ thời gian trì hoãn với siêu tham số và khảo sát cách điều chỉnh chúng để làm mạnh hoặc loại bỏ grokking.
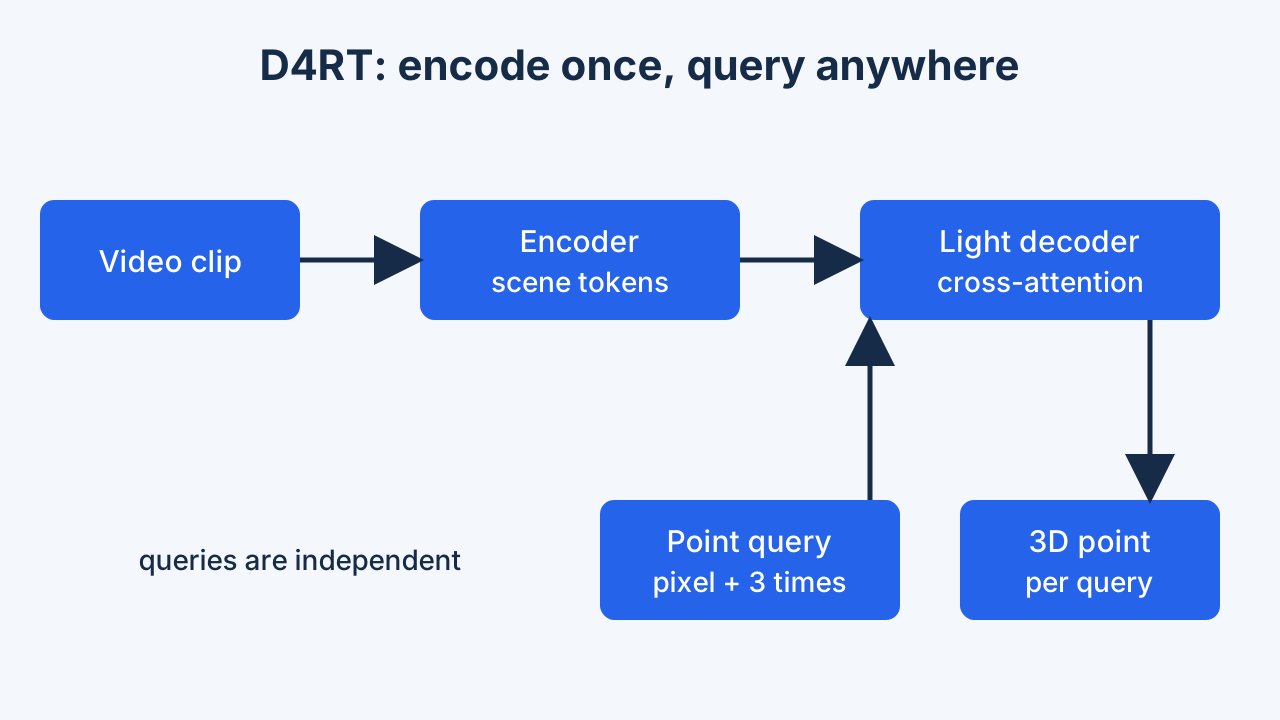
D4RT kết hợp ước lượng độ sâu, tương ứng không-thời gian và tham số camera từ video động. Một giao diện truy vấn điểm thống nhất thay thế nhiều decoder theo tác vụ, giúp khảo sát tái dựng cảnh 4D bằng mạng feed-forward.
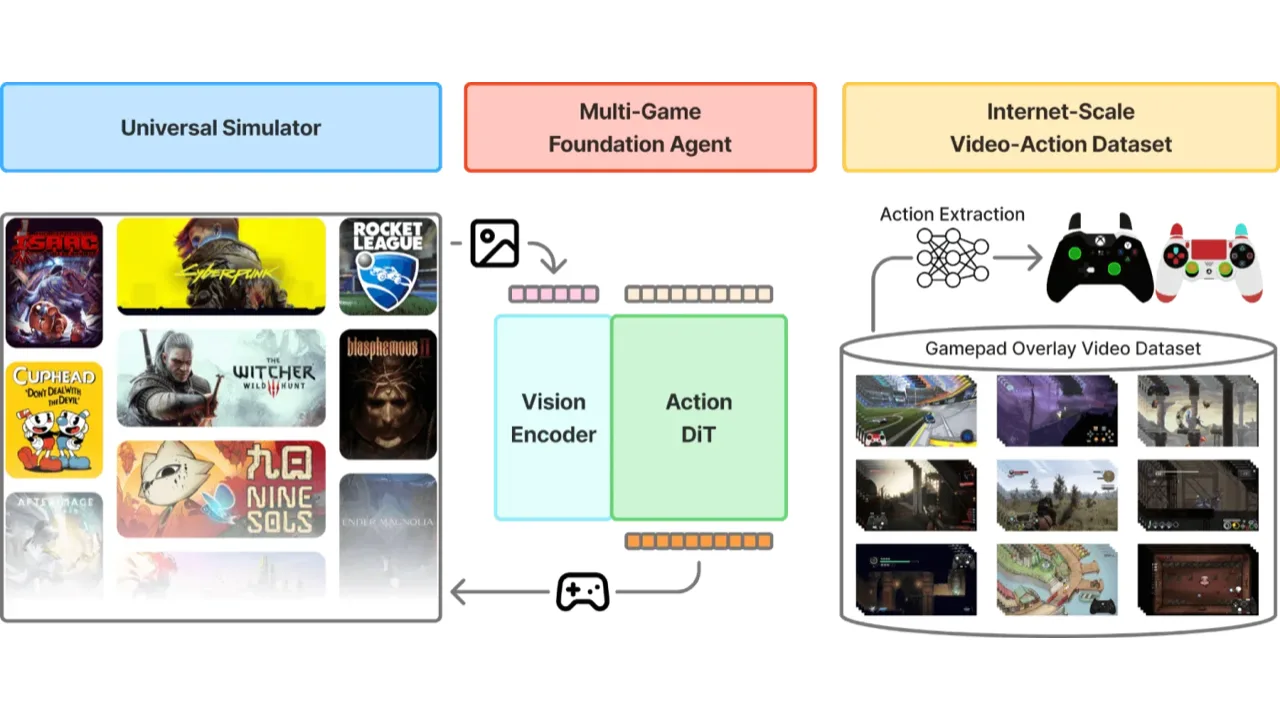
NitroGen nghiên cứu agent thị giác–hành động có thể chơi nhiều trò chơi. Dữ liệu hành động được trích từ video gameplay, kết hợp behavior cloning và môi trường đánh giá đa trò chơi để khảo sát khả năng chuyển giao sang trò chơi mới.
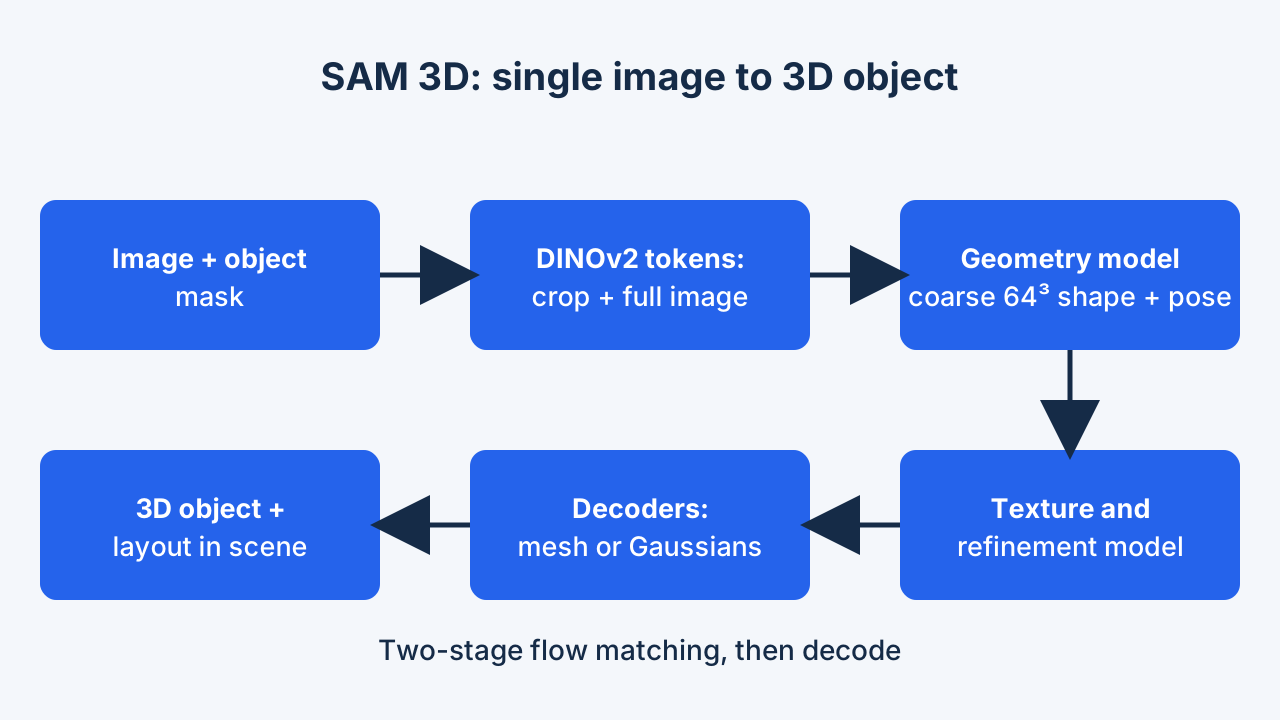
SAM 3D tái dựng hình học, texture và bố trí đối tượng từ một ảnh. Quy trình gán nhãn có con người và mô hình tham gia kết hợp pretraining tổng hợp với căn chỉnh dữ liệu thực để xử lý ảnh có che khuất và nền phức tạp.
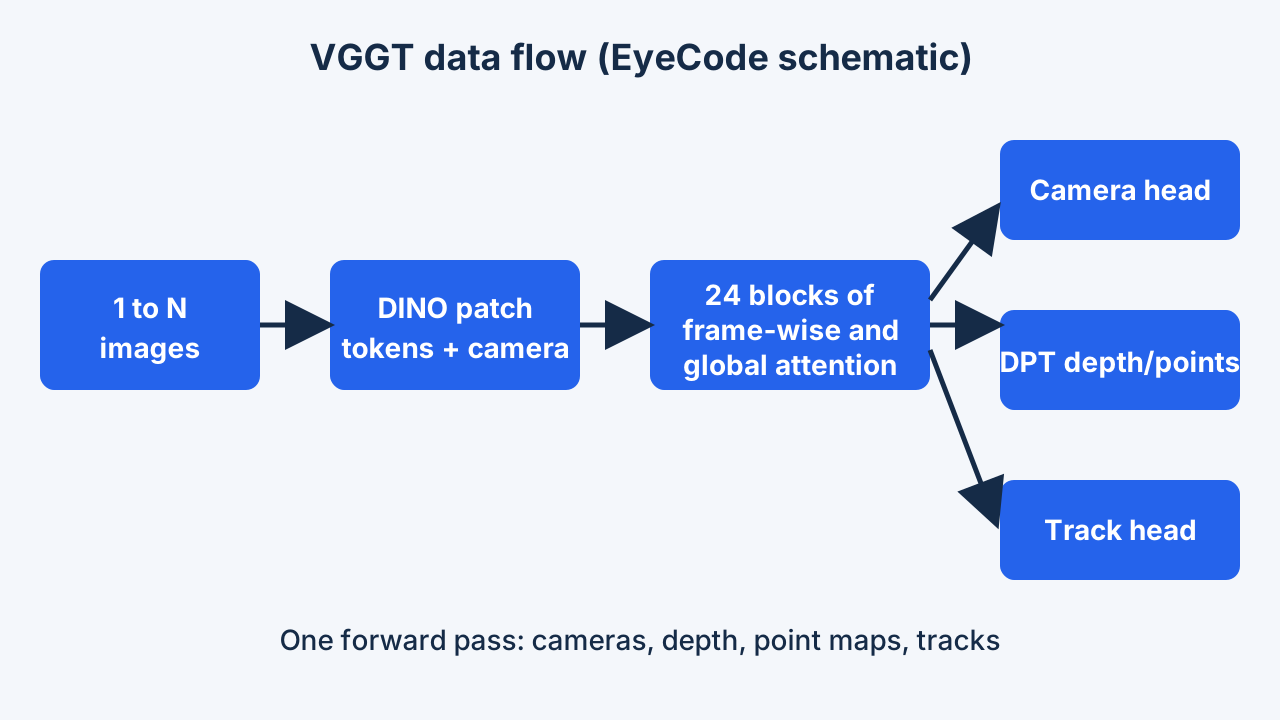
VGGT dùng một mạng feed-forward để suy ra camera, độ sâu, point map và quỹ đạo điểm từ một hoặc nhiều ảnh. Kiến trúc chung nghiên cứu cách học các thuộc tính hình học 3D liên quan trong cùng mô hình thay vì những bộ giải riêng biệt.
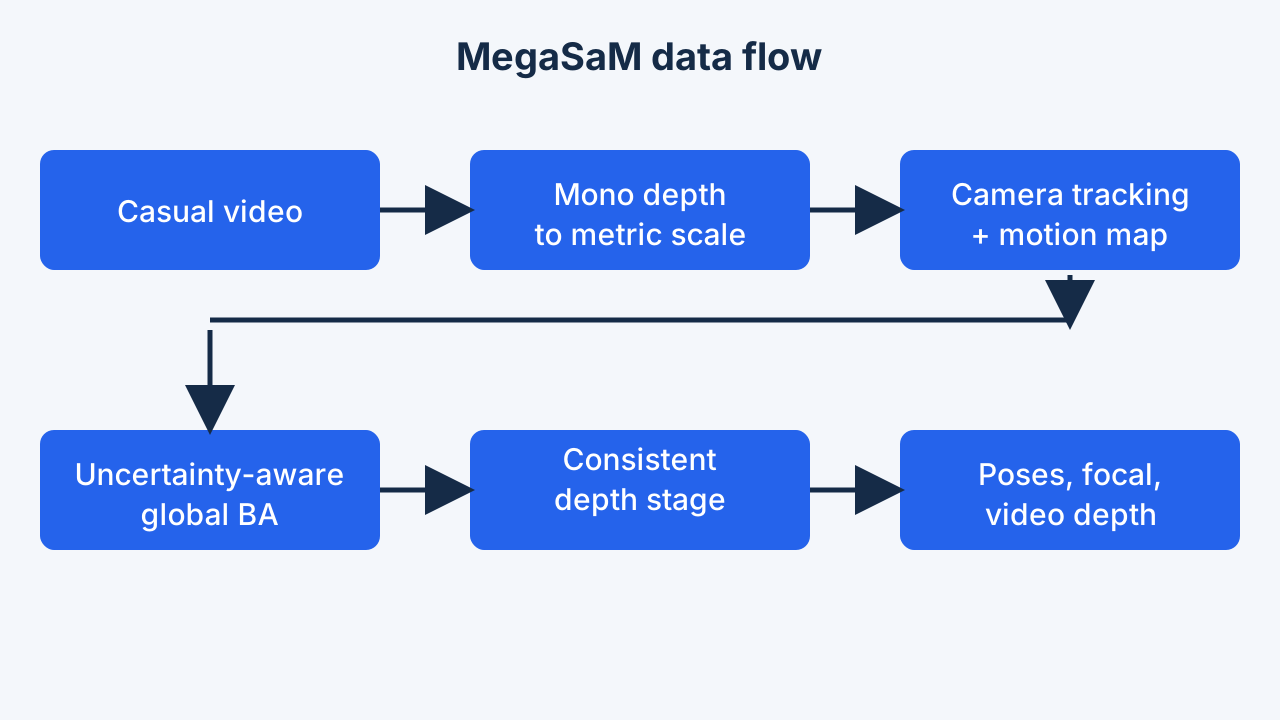
MegaSaM ước lượng camera và độ sâu từ video đơn mắt có chuyển động cảnh và camera không kiểm soát. Các thay đổi trong huấn luyện và suy luận của deep visual SLAM nhắm đến video đời thường mà giả định cảnh tĩnh không còn phù hợp.
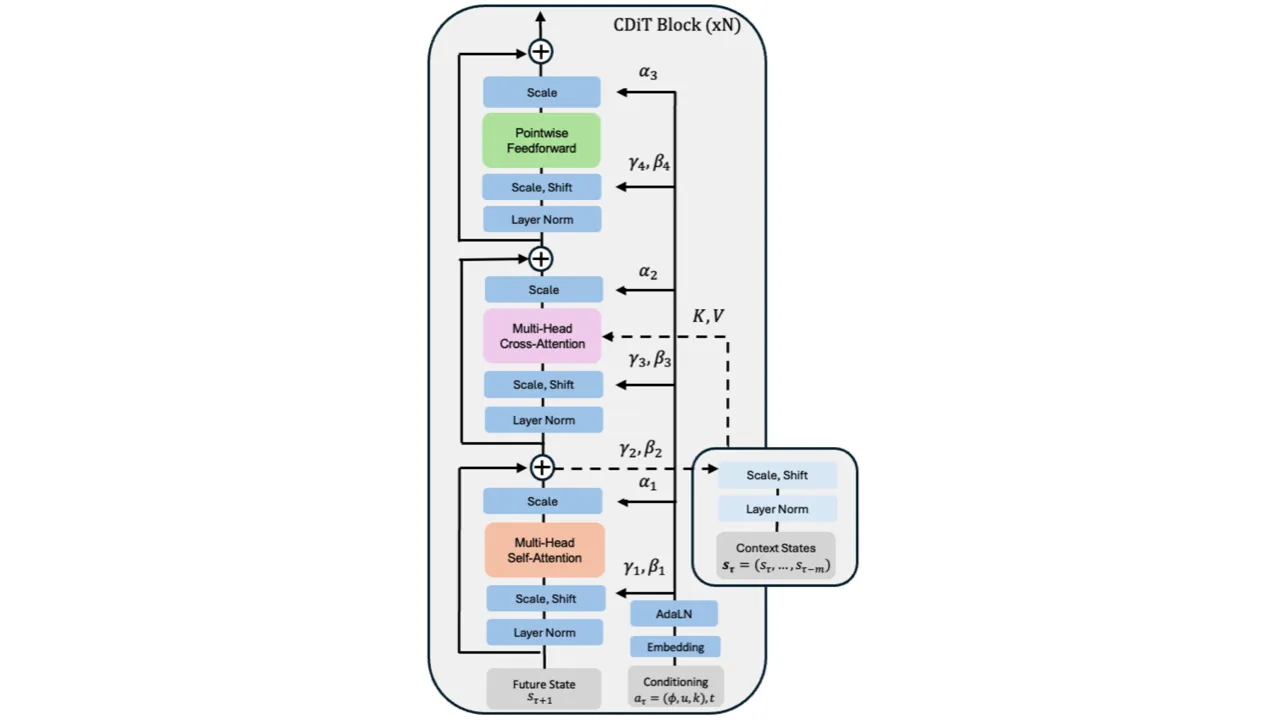
NWM dự đoán quan sát thị giác tương lai từ lịch sử và hành động điều hướng. Conditional Diffusion Transformer được dùng để mô phỏng, đánh giá quỹ đạo và đưa thêm ràng buộc vào lập kế hoạch thay vì cố định một chính sách hành động.
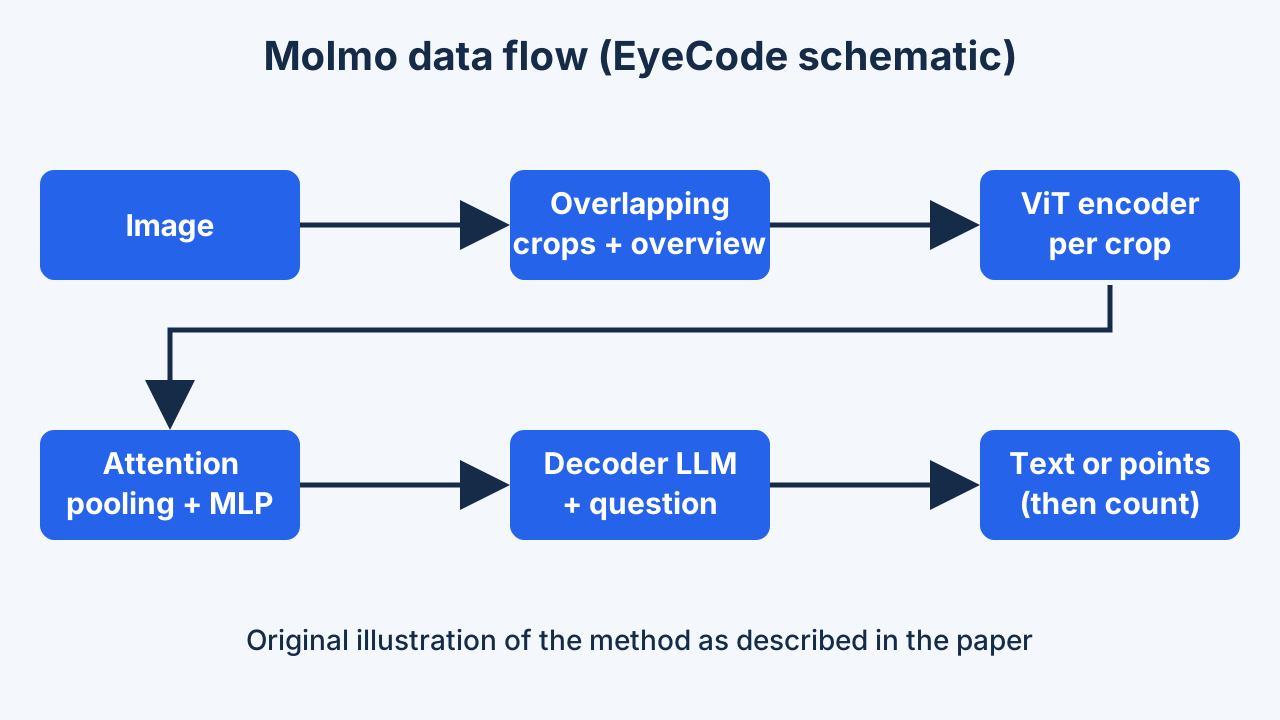
Molmo và PixMo nghiên cứu cách xây dựng mô hình thị giác–ngôn ngữ với dữ liệu và trọng số mở. Các bộ dữ liệu caption, hỏi đáp và chỉ điểm do con người thu thập cung cấp nền tảng để phân tích lựa chọn mô hình và quy trình huấn luyện.
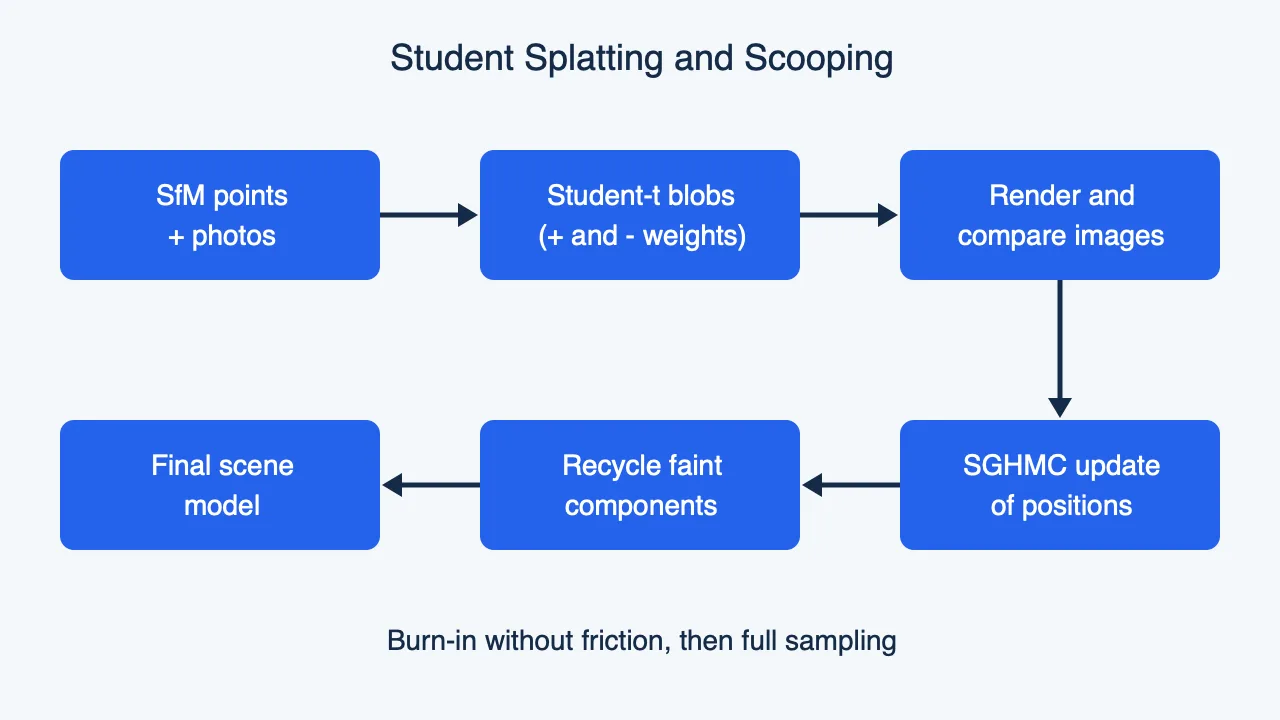
SSS xem lại biểu diễn hỗn hợp trong 3D Gaussian Splatting. Các phân phối Student có mật độ dương và âm cùng phương pháp lấy mẫu tối ưu hóa mới cho phép nghiên cứu biểu diễn cảnh ngoài giả định Gaussian thông thường.
BrickGPT sinh cấu trúc gạch lắp ghép từ mô tả văn bản. Mô hình autoregressive kết hợp kiểm tra tính hợp lệ và rollback dựa trên vật lý để ràng buộc thiết kế có thể đứng vững và lắp ráp được.
Bài báo nghiên cứu hệ quang học có thể lấy nét ở các độ sâu khác nhau theo từng vị trí ảnh. Lohmann lens và bộ điều biến ánh sáng pha kết hợp ước lượng contrast, disparity để điều chỉnh bản đồ lấy nét.
RayZer học dựng cảnh 3D từ các ảnh chưa biết camera mà không dùng giám sát hình học 3D. Mô hình tách biểu diễn camera và cảnh, dùng cấu trúc tia cùng việc dựng lại góc nhìn để học từ dữ liệu ảnh 2D.
Nghiên cứu tái dựng biến thiên ánh sáng từ timestamp photon mà không đồng bộ với nguồn sáng. Lý thuyết ước lượng flux và thuật toán miền Fourier cho phép phân tích chuyển động cảnh và tín hiệu ánh sáng ở nhiều thang thời gian.
ControlNet bổ sung điều kiện không gian cho mô hình text-to-image diffusion đã được huấn luyện. Nhánh điều khiển dùng zero-initialized convolutions để tiếp nhận cạnh, độ sâu hoặc pose trong khi bảo toàn backbone gốc.
Segment Anything xây dựng bài toán phân đoạn có thể điều khiển bằng prompt. Mô hình, quy trình thu thập dữ liệu tương tác và bộ dữ liệu mask quy mô lớn tạo nền tảng cho phân đoạn trên các ảnh và tác vụ mới.
Nghiên cứu thiết kế camera tối giản với pixel có hình dạng tự do theo từng nhiệm vụ. Phần cứng được mô hình hóa như lớp đầu mạng neural để học mặt nạ quang học, hướng tới cảm biến ít phép đo và hạn chế thông tin nhận dạng.
Bài báo kiểm tra giới hạn của việc chặn khái niệm trong text-to-image diffusion. Phân tích kết hợp nhiều khái niệm qua compositional inference làm rõ những lỗ hổng cần xem xét khi đánh giá cơ chế an toàn của mô hình.
Nghiên cứu xử lý gradient tại biên che khuất trong differentiable rasterization. Khái niệm micro-edge xấp xỉ quá trình liên tục phía sau pixel rời rạc, cho phép tối ưu hình học mà không phải thay đổi ảnh của forward pass.
HKTex biểu diễn texture trực tiếp trên mặt lưới tam giác bằng anisotropic heat kernels. Tối ưu vị trí và mật độ trên đa tạp thay thế UV unwrapping, hỗ trợ học texture từ ảnh đa góc nhìn hoặc texture sẵn có.
LSRM mở rộng cửa sổ ngữ cảnh trong tái dựng đối tượng 3D bằng sparse attention. Pipeline thô đến tinh, định tuyến theo hình học và sequence parallelism tập trung tính toán vào vùng giàu thông tin để học hình học và vật liệu.
Poppy dùng ảnh phân cực để tinh chỉnh pháp tuyến bề mặt từ backbone RGB đã đóng băng. Tối ưu offset đầu vào, đầu ra và phân rã phản xạ qua differentiable rendering đưa thêm ràng buộc vật lý ở thời điểm suy luận.
OmniRetarget chuyển động tác người sang robot humanoid bằng cách bảo toàn quan hệ giữa cơ thể, vật thể và địa hình. Interaction mesh cùng ràng buộc động học tạo dữ liệu chuyển động và tăng cường dữ liệu cho loco-manipulation.
Bài báo xây dựng công thức marginalization và conditioning Gaussian trên đa tạp tuyến tính tổng quát. Tuyến tính hóa mở rộng phương pháp sang đa tạp trơn, với các ứng dụng ước lượng covariance trong SLAM và tối ưu có ràng buộc.
MAC-VO đưa độ không chắc chắn theo đơn vị đo vào visual odometry stereo. Covariance được học phục vụ chọn keypoint và gán trọng số residual, liên kết độ tin cậy của phép ghép ảnh với tối ưu pose graph.
LT-Mem duy trì lịch sử và danh tính đối tượng khi robot quay lại môi trường thay đổi theo thời gian. Bộ nhớ Live, Delta và Meta được cập nhật theo mức biến động, kết hợp dữ liệu nhiều phiên để hỗ trợ truy vấn lịch sử cảnh.
Nghiên cứu điều khiển chọn lọc các bộ truyền động cơ xương trong robot sinh học–cơ điện. Điện cực màng mỏng dạng đan xen được tối ưu để kích thích những vùng cơ khác nhau, hỗ trợ phối hợp nhiều đơn vị truyền động.
Nghiên cứu học chính sách thống nhất cho điều khiển vị trí và lực ở robot có chân. Học tăng cường trong mô phỏng dùng lịch sử trạng thái để ước lượng lực và bù chuyển động, hỗ trợ thao tác tiếp xúc mà không cần cảm biến lực.
Fabrica kết hợp lập kế hoạch phân cấp với chính sách điều khiển học được cho lắp ráp hai tay robot. Hệ thống liên kết thứ tự lắp, chọn grasp và đường đi với điều khiển tiếp xúc cục bộ trên các hình học đa chi tiết.
PoliFormer học điều hướng trong nhà từ ảnh RGB bằng học tăng cường quy mô lớn trong mô phỏng. Vision encoder và causal Transformer cung cấp biểu diễn quan sát cùng bộ nhớ lịch sử để nghiên cứu chuyển giao sang robot thực.
Nghiên cứu điều khiển xe gần giới hạn bám đường bằng mô hình diffusion có điều kiện. Phân phối tham số động lực học gắn kiến thức vật lý được cập nhật từ đo lường trực tuyến và tích hợp vào model predictive control.
FlashSAC nghiên cứu tính ổn định của off-policy RL cho robot có không gian điều khiển lớn. Giới hạn norm trọng số, đặc trưng và gradient kết hợp mô phỏng song song cùng replay buffer để hạn chế khuếch đại sai số critic.
FEAST hỗ trợ cá nhân hóa robot trợ giúp bữa ăn trong môi trường gia đình. Phần cứng mô-đun, nhiều phương thức tương tác và behavior tree có tham số cho phép điều chỉnh việc ăn, uống và lau miệng theo nhu cầu người dùng.
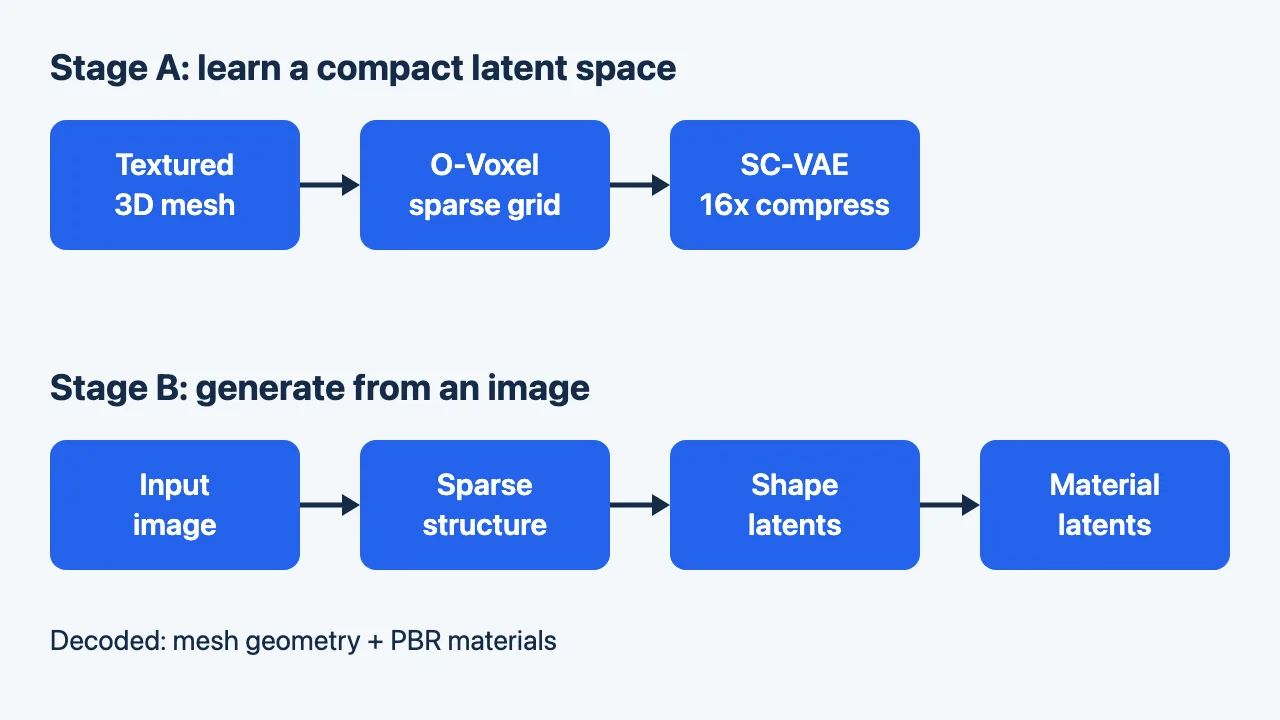
Bài báo đề xuất O-Voxel, biểu diễn voxel thưa lưu cả hình học lẫn vật liệu PBR, cùng SC-VAE nén 16 lần để một tài sản 1024 có texture chỉ còn khoảng 9,6K token. Các mô hình flow-matching tổng cộng khoảng 4B tham số sinh hình dạng và vật liệu từ ảnh, được báo cáo vượt các baseline về tái tạo và sinh trên các thử nghiệm của tác giả.
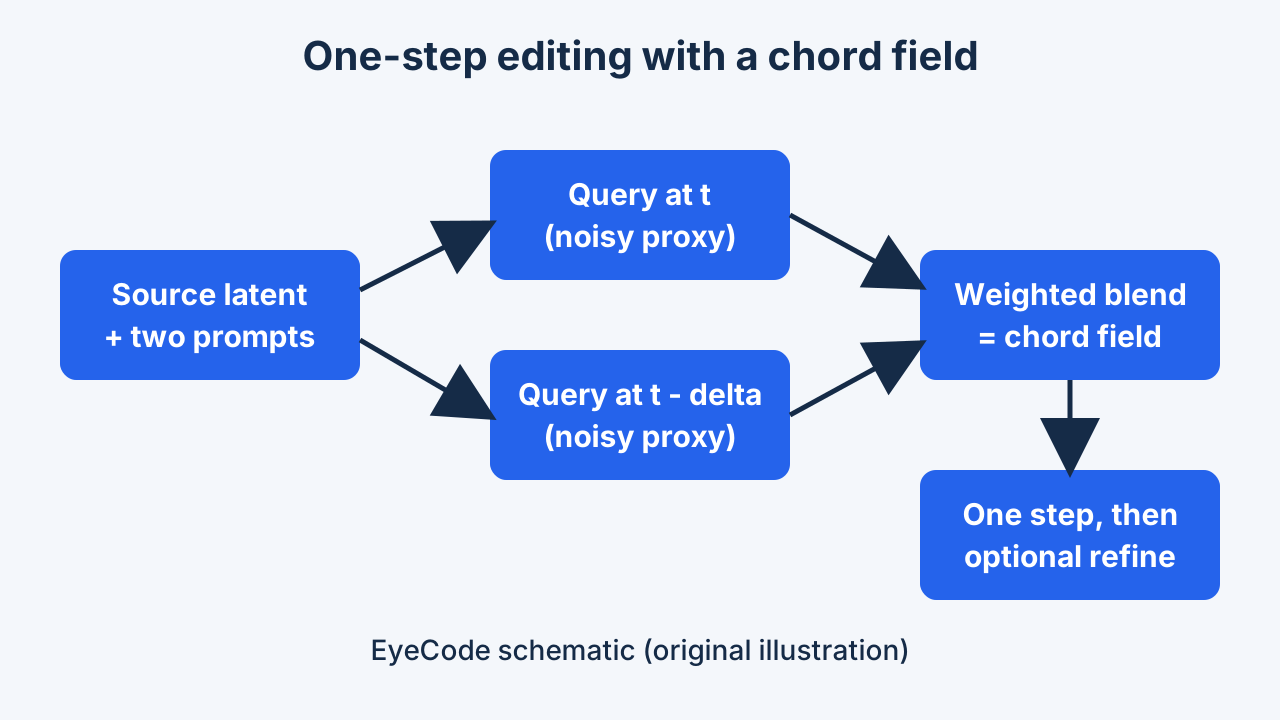
ChordEdit chỉnh sửa ảnh theo văn bản chỉ trong một bước cho các mô hình sinh ảnh một bước, không cần huấn luyện hay inversion, bằng trường điều khiển năng lượng thấp suy ra từ vận chuyển tối ưu động. Trên PIE-bench bản đầy đủ chạy 0,38 giây.
Chưa có bài báo đã xác minh phù hợp với bộ lọc này. Hãy chọn hội nghị, năm hoặc loại bài báo khác.