
Efficiently Reconstructing Dynamic Scenes One D4RT at a Time
D4RT là transformer feed-forward mã hóa video một lần, rồi trả lời các truy vấn điểm nhẹ để khôi phục độ sâu, quỹ đạo điểm, đám mây điểm và tham số camera trong một mô hình duy nhất.
Tổng quan
Hãy tưởng tượng bạn quay một con phố bằng điện thoại. D4RT là chương trình xem đoạn clip đúng một lần rồi trả lời được nhiều câu hỏi: điểm ảnh này cách bao xa, chiếc xe đạp kia đi đâu trong vài giây tới, và camera đã di chuyển thế nào. Một mô hình duy nhất lo tất cả, thay vì mỗi việc một công cụ, và trả lời khá nhanh.
D4RT (Dynamic 4D Reconstruction and Tracking), của Google DeepMind, UCL và Oxford, khôi phục hình học 3D và chuyển động của một cảnh động từ một video duy nhất [1]. Mục tiêu là thay các hệ thống riêng cho depth, tracking và ước lượng camera bằng một mô hình. Đóng góp chính gồm giao diện truy vấn hỏi vị trí 3D của bất kỳ pixel nào tại bất kỳ thời điểm nào, một decoder nhẹ trả lời từng truy vấn độc lập, và kết quả tốt trên các benchmark depth, point cloud, pose và tracking cùng thông lượng tracking cao hơn hẳn [1]. CVPR 2026 liệt kê bài trong nhóm Best Paper [4].
D4RT (Dynamic 4D Reconstruction and Tracking) là transformer encoder-decoder theo dòng Scene Representation Transformer. Encoder ánh xạ video V gồm T khung hình thành biểu diễn cảnh toàn cục F có N token. Decoder cross-attention từ một truy vấn q vào F và trả về một điểm 3D, P = D(q, F). Depth, track, point cloud, extrinsics và intrinsics chỉ là các cách chọn tập truy vấn khác nhau. Bài nhấn mạnh ba tính chất: các chỉ số thời gian không cần trùng nhau, mỗi truy vấn được giải mã độc lập, và một giao diện phục vụ mọi tác vụ [1].
Bài toán nghiên cứu
Các hệ thống cũ giải từng mảnh: một cái cho depth, một cái cho tracking, một cái cho camera. Chúng chậm, và dễ hỏng khi vật trong cảnh chuyển động vì được thiết kế cho thế giới đứng yên. Câu hỏi là liệu một mô hình nhanh có làm được tất cả hay không.
Hiểu một cảnh động nghĩa là trả lời các câu hỏi liên đới: mỗi pixel cách bao xa, mỗi điểm di chuyển ra sao, và camera ở đâu. Các hệ thống trước xử lý chúng riêng rẽ. MegaSaM ghép nhiều mô hình có sẵn và cần tối ưu lúc test, VGGT dùng decoder riêng cho từng đầu ra và không có tương ứng cho phần động, còn SpatialTrackerV2 cần tinh chỉnh lặp tốn kém và chỉ theo dõi điểm từ một khung [1]. Theo dõi mọi pixel xuyên suốt video cũng rất tốn kém. Khoảng trống nghiên cứu là một mô hình duy nhất, nhanh, xử lý cả tái dựng lẫn tracking, điều quan trọng với mọi hệ thống phải hiểu cảnh chuyển động.
Bài toán là tái dựng 4D và tracking đồng thời từ video đơn. Các mô hình chỉ tái dựng (MegaSaM, pi3) cộng dồn point cloud và hỏng khi có chuyển động, ví dụ lặp lại con thiên nga ở Hình 4 hoặc bỏ sót bông hoa. Các mô hình dựa trên tracking nắm được chuyển động nhưng để lại khoảng trống ở vùng bị che trong khung đầu. Nhiều mô hình feed-forward cũng không hỗ trợ intrinsics thay đổi trong video hoặc chỉ dùng khung đầu làm tham chiếu.
Chi phí là trở ngại thứ hai. Theo dõi mọi pixel tới mọi khung theo cách ngây thơ cần cỡ T bình phương nhân H nhân W truy vấn; bài báo nói các decoder dày theo khung bị mắc kẹt ở mức đó, còn các mô hình có decoder thưa nặng phải trả chi phí lớn cho mỗi truy vấn. Mục tiêu thiết kế vì vậy là cách phát biểu mà chi phí do số điểm được hỏi quyết định, không có head riêng cho từng tác vụ.
Ý tưởng chính
Hãy nghĩ đến việc đọc một cuốn sách một lần rồi trả lời mọi câu hỏi về nó. D4RT đọc video một lần. Sau đó bạn chỉ vào bất kỳ chỗ nào ở bất kỳ khung nào và hỏi nó nằm ở đâu trong 3D vào thời điểm khác. Mỗi câu hỏi được trả lời riêng, nên bạn chỉ trả giá cho những câu mình hỏi.
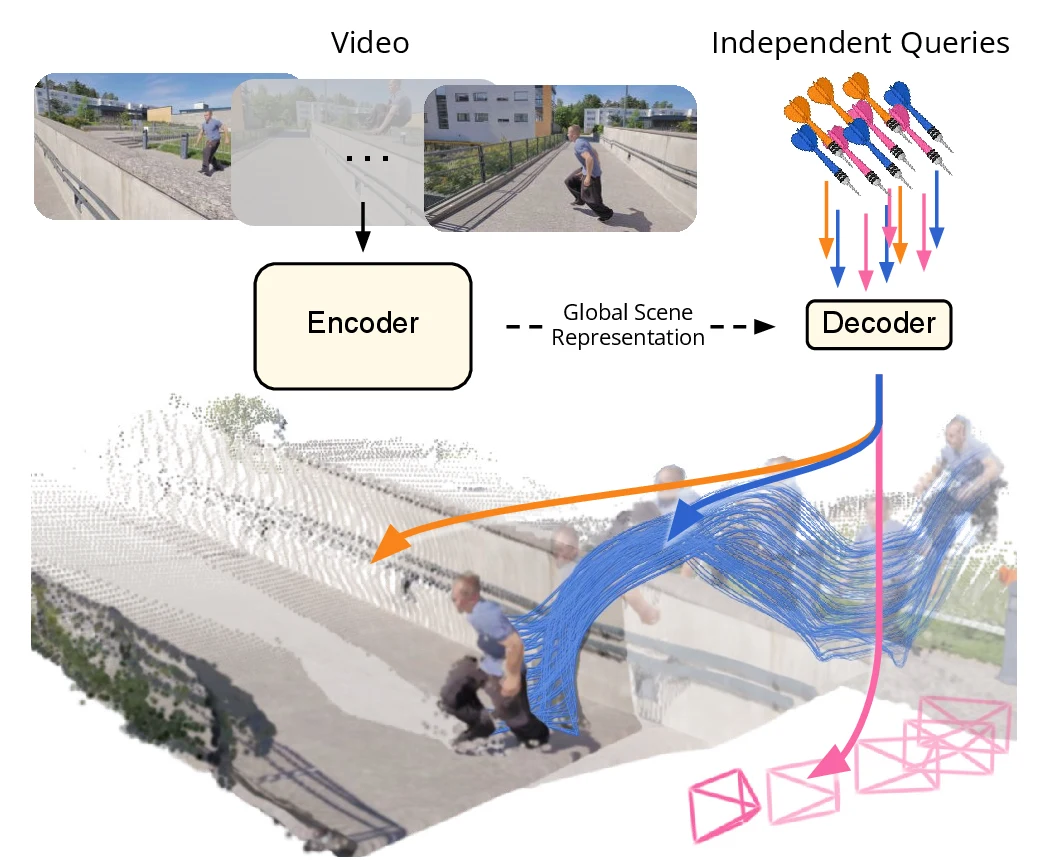
D4RT mã hóa video một lần rồi trả lời các truy vấn điểm. Một truy vấn gồm vị trí pixel (u, v) ở khung nguồn cùng ba chỉ số thời gian: khung nguồn, khung đích nơi cần biết vị trí 3D, và khung camera mà đáp án được biểu diễn theo đó. Decoder trả về một điểm 3D (Hình 1) [1].
Cố định các chỉ số khác nhau cho các tác vụ khác nhau. Cố định một pixel và cho thời gian đích chạy hết video: được track 3D. Hỏi mọi pixel với ba chỉ số thời gian bằng nhau rồi giữ Z: được depth map. Dùng một thời gian camera chung: được point cloud trong một hệ tọa độ. Vì các truy vấn độc lập, chi phí tăng theo số điểm được hỏi.
Truy vấn là q = (u, v, t_src, t_tgt, t_cam), với (u, v) trong [0,1]^2 và các thời điểm trong 1..T. Pose tương đối giữa khung i và j: giải mã một lưới (h, w) điểm nguồn với t_src = t_tgt = i, một lần với t_cam = i và một lần với t_cam = j; hai tập điểm mô tả cùng các điểm 3D trong hai hệ camera, và phép biến đổi cứng giữa chúng lấy từ nghiệm đóng SVD 3x3 của Umeyama. Intrinsics: cố định principal point ở (0.5, 0.5), f_x = p_z (u - 0.5) / p_x và f_y = p_z (v - 0.5) / p_y cho từng điểm, rồi lấy trung vị. Camera có méo ống kính sẽ cần thêm bước tinh chỉnh phi tuyến.
Dense tracking (Thuật toán 1) đánh dấu các pixel mà track đã giải mã đi qua và chỉ lấy mẫu những pixel chưa thăm; bài báo ghi nhận tăng tốc thích ứng 5 đến 15 lần so với số truy vấn ngây thơ [1].
Phương pháp
Một video, cùng các truy vấn điểm không-thời gian (vị trí pixel và ba chỉ số thời gian).
Encoder video dựng biểu diễn cảnh toàn cục; decoder truy vấn đọc biểu diễn đó.
Trực tiếp: một điểm 3D cho mỗi truy vấn.
Suy ra từ các điểm đó: depth map, point track, point cloud, camera pose và intrinsics.
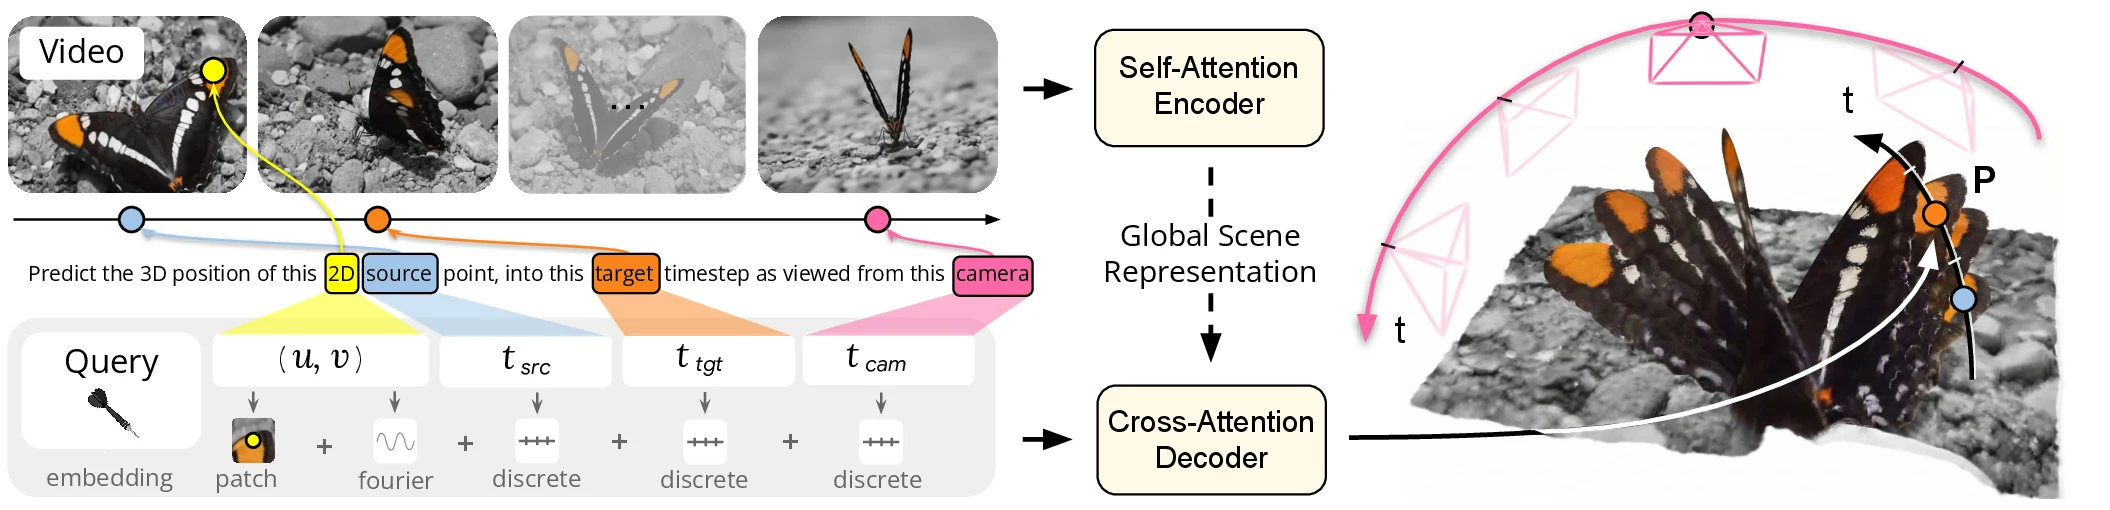
Một mạng nơ-ron lớn, gọi là encoder, xử lý toàn bộ video một lần và lưu lại những gì học được thành một biểu diễn cảnh gọn. Một mạng nhỏ, gọi là decoder, nhận một truy vấn, chẳng hạn một pixel nằm ở đâu trong 3D tại thời điểm khác, tra biểu diễn đó và trả về một điểm 3D (Hình 2).
Hai phần được huấn luyện cùng nhau trên các video có thông tin 3D, gồm cả tổng hợp và thực. Mục tiêu huấn luyện là giảm khoảng cách giữa các điểm 3D dự đoán và các điểm 3D thật.
Như Hình 2 cho thấy, encoder Vision Transformer (ViT-g, khoảng 1 tỷ tham số) với self-attention xen kẽ theo từng khung và toàn cục xử lý toàn bộ video một lần và cho ra biểu diễn cảnh toàn cục. Một decoder cross-attention nhỏ (8 lớp, 144 triệu tham số) nhận một truy vấn, cross-attend vào biểu diễn này và trả về vị trí 3D. Các truy vấn attend vào biểu diễn nhưng không attend lẫn nhau, nên mỗi truy vấn được giải mã độc lập [1].
Mỗi truy vấn kết hợp embedding của (u, v), embedding học được của ba chỉ số thời gian và một patch RGB 9x9 nhỏ quanh pixel, cung cấp cho decoder tín hiệu hình ảnh cục bộ để tìm tương ứng và làm biên vật thể sắc nét hơn [1]. Mục tiêu huấn luyện là loss L1 giữa vị trí 3D dự đoán và vị trí 3D ground truth, nhân với confidence dự đoán, cùng các số hạng phụ nhỏ; huấn luyện dùng clip 48 khung ở 256x256 [1].
Encoder là Vision Transformer với self-attention xen kẽ theo từng khung và toàn cục (ViT-g: 40 lớp, khoảng 1 tỷ tham số), cho F thuộc R^(N x C). Decoder 8 lớp, 144 triệu tham số cross-attend từ một truy vấn vào F và trả về P = D(q, F), đúng luồng dữ liệu của Hình 2 [1]. Phụ lục D so sánh khởi tạo ngẫu nhiên với trọng số VideoMAE đã pretrain cho encoder: AbsRel (chỉ scale) trên Sintel là 0.738 so với 0.302 và ATE 0.334 so với 0.091 (Bảng 11).
Truy vấn. q = (u, v, t_src, t_tgt, t_cam), với (u, v) được nhúng Fourier, embedding thời gian học được và patch RGB 9x9 quanh pixel; Hình 2 cho thấy cách chọn ba chỉ số thời gian cho ra từng tác vụ. Theo lý giải của tác giả (Mục 4.4 của [1]), patch giúp truy vấn tìm tương ứng đáng tin hơn với đặc trưng đã mã hóa và cung cấp tín hiệu mức thấp để biên vật thể sắc nét.
Tổng loss lấy trung bình trên các truy vấn mẫu: số hạng L1 3D nhân confidence (trọng số 1.0) trừ phạt log-confidence (0.2), cộng L1 vị trí 2D (0.1), binary cross-entropy cho visibility (0.1), L1 cho displacement (0.1) và cosine similarity cho normal (0.5) [1]. Phương trình ở phụ lục liệt kê trọng số confidence hai lần, có vẻ là ký hiệu bị lặp. Mọi số hạng chỉ áp dụng nơi có ground truth.
Thực nghiệm & kết quả
D4RT được huấn luyện trên hỗn hợp dữ liệu công khai (ví dụ PointOdyssey, Kubric, ScanNet và Waymo Open) cùng dữ liệu nội bộ [1]. Mô hình được đánh giá trên tracking 3D (TAPVid-3D), video depth và point cloud (Sintel, ScanNet, KITTI, Bonn) và camera pose (Sintel, ScanNet), với các chỉ số như AJ, AbsRel, ATE và RPE. Tốc độ được đo bằng số track 3D toàn video mà một GPU A100 tạo được ở một mức FPS mục tiêu [1].
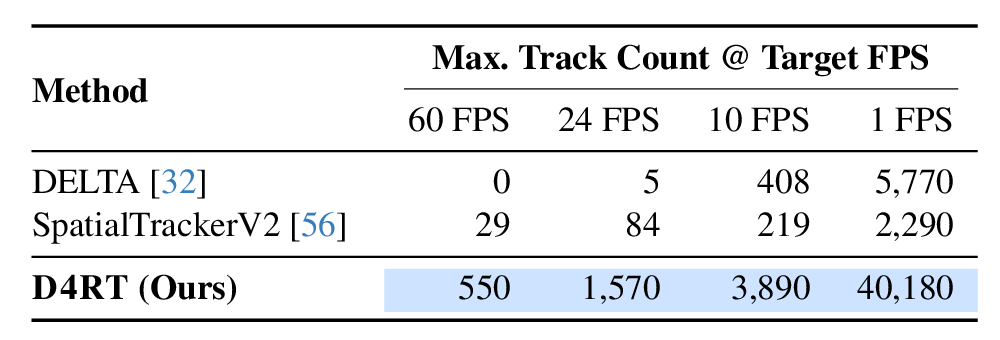
Trong phép thử tốc độ của bài báo, mô hình theo dõi được hàng chục nghìn điểm trong video trong khi hai phương pháp còn lại chỉ vài nghìn (ở mục tiêu 1 FPS, Bảng 3). Độ chính xác được đo riêng, và mô hình không đứng đầu ở mọi phép thử.
- Bảng 3 đo tốc độ, không đo độ chính xác: số track 3D toàn video tối đa mà mỗi phương pháp tạo được trên một GPU A100 khi giữ một mức FPS mục tiêu [1]. Ở 1 FPS, D4RT hỗ trợ 40.180 track so với 5.770 (DELTA) và 2.290 (SpatialTrackerV2).
- Độ chính xác được báo cáo riêng, trong các bảng depth, point cloud, pose và tracking của bài báo, nơi D4RT dẫn đầu ở phần lớn nhưng không phải mọi benchmark (ví dụ π³ tốt hơn ở depth Bonn) [1].
- So sánh tốc độ chỉ gồm hai baseline và một loại GPU, nên không chứng tỏ ưu thế trên phần cứng hoặc tác vụ khác [1].
- Bảng 3 đo tốc độ, không đo độ chính xác: số track 3D toàn video tối đa mà mỗi phương pháp tạo được trên một GPU A100 khi giữ một mức FPS mục tiêu [1]. Ở 1 FPS, D4RT hỗ trợ 40.180 track so với 5.770 (DELTA) và 2.290 (SpatialTrackerV2).
- Độ chính xác được báo cáo riêng, trong các bảng depth, point cloud, pose và tracking của bài báo, nơi D4RT dẫn đầu ở phần lớn nhưng không phải mọi benchmark (ví dụ π³ tốt hơn ở depth Bonn) [1].
- So sánh tốc độ chỉ gồm hai baseline và một loại GPU, nên không chứng tỏ ưu thế trên phần cứng hoặc tác vụ khác [1].
Thông lượng đếm track toàn video, mỗi track gồm T truy vấn decoder độc lập. Chú thích và bài blog của DeepMind [3] nêu D4RT nhanh hơn 18 đến 300 lần, nhưng chia các ô cho khoảng 7 đến 314 lần, nên dải này không bao phủ mọi ô. Ablation đáng nhớ: bỏ patch RGB cục bộ làm AbsRel (chỉ scale) trên Sintel tăng từ 0.302 lên 0.366 và ATE từ 0.091 lên 0.173 (Bảng 7) [1].
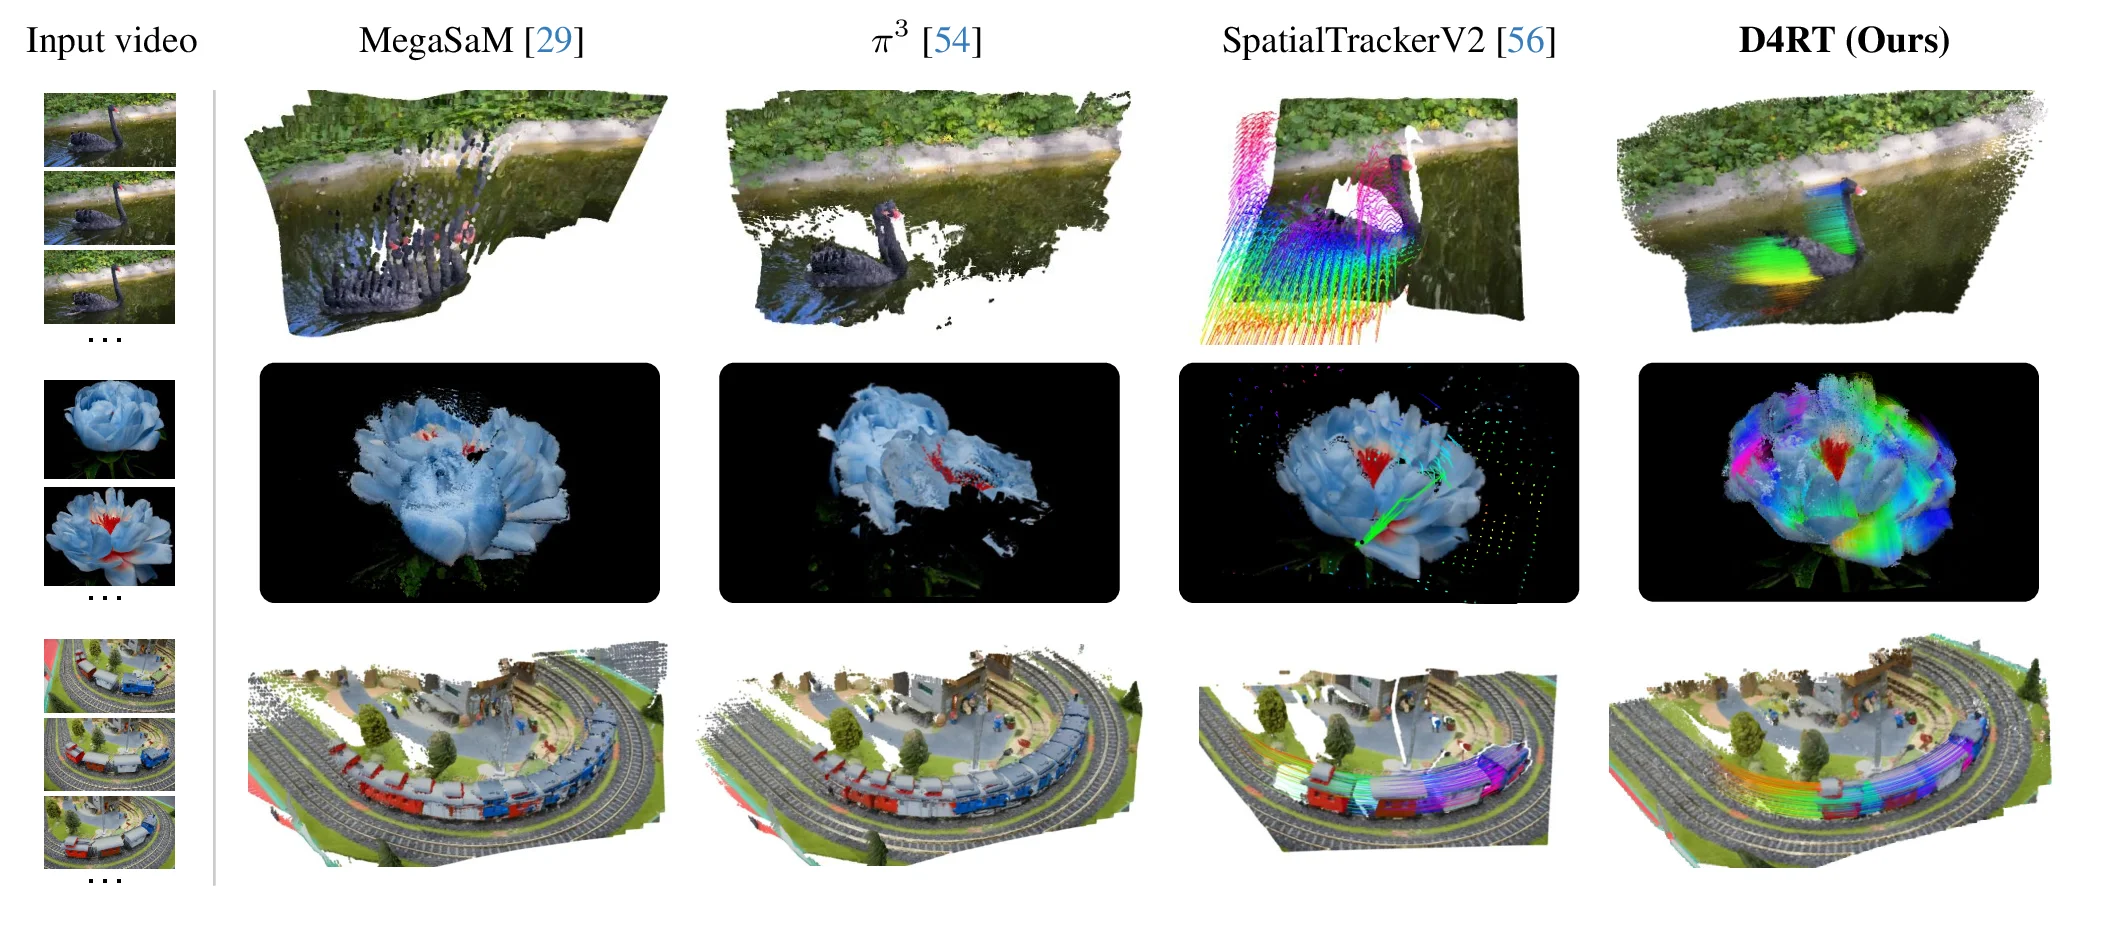
Ở Hình 4, MegaSaM lặp lại con thiên nga đang di chuyển và π³ bỏ sót bông hoa, còn SpatialTrackerV2, vốn chỉ theo dõi điểm từ một khung, để lại khoảng trống trong bản dựng. Theo tác giả, D4RT là phương pháp duy nhất trong hình khôi phục được biểu diễn 4D đầy đủ của cảnh [1]. Đây là so sánh minh họa, không phải phép đo định lượng.
Hạn chế
Bài báo không có mục hạn chế. Tác giả nêu một số giả định đơn giản hóa, và kết quả video dài chỉ được trình bày bằng hình ảnh, không đo lường.
- Do tác giả nêu: bài báo không có mục hạn chế riêng. Thử nghiệm video dài chỉ định tính và cố ý bỏ phát hiện loop cùng tối ưu toàn cục, nên drift đường dài không được định lượng [1].
- Giả định do tác giả nêu: principal point được cố định ở tâm ảnh, và méo ống kính cần một bước tinh chỉnh phi tuyến riêng [1].
- Suy luận, không do tác giả nêu: các ablation dùng mô hình ViT-L nhỏ hơn và chỉ trên Sintel, nên có thể không áp dụng cho mô hình đầy đủ; và vì bài báo lẫn trang dự án không liên kết tới mã (kiểm tra ngày 9/11/2026) [1][2], việc tái lập độc lập hiện khó hơn.
- Có căn cứ từ tác giả: kết quả video dài chỉ định tính, cố ý bỏ phát hiện loop và tối ưu toàn cục; principal point được giả định ở tâm ảnh; intrinsics pinhole suy ra từ điểm đã decode và méo ống kính cần tinh chỉnh phi tuyến [1].
- Suy luận, không do tác giả nêu: pose và intrinsics được suy ra từ dự đoán điểm nên sai số điểm lan sang chúng, và việc huấn luyện ở 256x256 phù hợp với khảo sát patch độ phân giải cao ở phụ lục. Ablation dùng ViT-L nhỏ hơn và chỉ trên Sintel, nên có thể không chuyển sang ViT-g.
- Tái lập (suy luận của chúng tôi): 64 chip TPU, dữ liệu nội bộ không liệt kê và không có bản phát hành mã được liên kết (kiểm tra ngày 9/11/2026) [1][2].
Ứng dụng & điểm cần nhớ
Đã được chứng minh trong bài báo: depth, point track, point cloud, camera pose và intrinsics từ một mô hình, được đánh giá trên các benchmark công khai và trình bày định tính trên cảnh động [1]. Các hướng ứng dụng tiềm năng, bài báo không đánh giá: robotics, thực tế tăng cường, điện toán không gian và dựng video.
Một mô hình trả lời nhiều câu hỏi khác nhau về video bằng cách dự đoán điểm 3D chỉ ở những chỗ bạn hỏi. Depth, chuyển động và vị trí camera đều đến từ cùng một kiểu câu hỏi, đó là lý do nó có thể nhanh.
- Ý tưởng trung tâm: mã hóa video một lần, rồi giải mã các truy vấn điểm độc lập thành vị trí 3D.
- Năng lực thống nhất: depth, track, point cloud và tham số camera đến từ một giao diện thay vì các head riêng cho từng tác vụ.
- Ý nghĩa thực tiễn: chi phí tăng theo số truy vấn, giúp dense tracking và ước lượng pose hiệu quả hơn; nên đọc mức cải thiện theo từng benchmark [1].
- Bài học thiết kế: tách mã hóa cảnh một lần khỏi giải mã từng điểm rẻ và độc lập.
- Bài học ablation: patch embedding, khởi tạo VideoMAE và từng loss phụ đều có tác động rõ trên Sintel, kèm đánh đổi giữa depth và pose.
- Các đại lượng suy ra (pose qua Umeyama, tiêu cự qua trung vị) gắn với độ chính xác của điểm.
Tài liệu tham khảo
- Efficiently Reconstructing Dynamic Scenes One D4RT at a TimeBài báo hội nghị, CVPR 2026 (arXiv:2512.08924)
- D4RT project pageTrang dự án
- D4RT: Unified, Fast 4D Scene Reconstruction & TrackingBài blog, Google DeepMind (22/01/2026)
- CVPR 2026 Best PapersThông báo giải thưởng, CVPR 2026
Các hình và Bảng 3 được lấy từ bài báo gốc [1] để minh họa; bản quyền thuộc về các tác giả (arXiv non-exclusive license). Quyền tái sử dụng chưa được xác nhận.