
3D Student Splatting and Scooping
SSS xem lại biểu diễn hỗn hợp trong 3D Gaussian Splatting. Các phân phối Student có mật độ dương và âm cùng phương pháp lấy mẫu tối ưu hóa mới cho phép nghiên cứu biểu diễn cảnh ngoài giả định Gaussian thông thường.
Bài này đọc kỹ 3D Student Splatting and Scooping; trang giải thưởng của hội nghị ghi bài đạt Best Paper Honorable Mention tại CVPR 2025. Chúng tôi tóm tắt phương pháp, các số trong bảng của bài và những hạn chế mà tác giả tự nêu. Phần ghi là phân tích của EyeCode là nhận định biên tập, không phải đánh giá chính thức.
Tổng quan
Hãy hình dung một cảnh 3D là đống đốm sáng mềm được nhìn từ nhiều góc máy ảnh. Các phương pháp cũ dùng một loại đốm và chỉ biết cộng thêm ánh sáng. Bài này cho đốm có độ dày mép chỉnh được, và cho một số đốm lấy bớt ánh sáng đi, giống như múc kem. Cùng một cách huấn luyện khác, tác giả báo cáo ảnh tương đương hoặc tốt hơn, và tốt hơn nhiều khi chỉ cho phép ít đốm.
3D Student Splatting and Scooping (SSS) là của Jialin Zhu, Jiangbei Yue, Feixiang He và He Wang. Trang giải thưởng CVPR 2025 liệt kê bài là Best Paper Honorable Mention. Bài cải tiến 3D Gaussian Splatting (3DGS), một cách phổ biến để render góc nhìn mới của cảnh từ ảnh chụp.
3DGS lưu cảnh dưới dạng nhiều đốm Gaussian được cộng lại. SSS thay đổi ba thứ: mỗi đốm là phân phối Student's t có đuôi học được, một số đốm mang mật độ âm nên trừ bớt, và huấn luyện dùng bộ tối ưu lấy mẫu (SGHMC) thay vì gradient descent thường. Trên 11 cảnh từ ba bộ dữ liệu chuẩn, bài báo cáo chất lượng cạnh tranh hoặc tốt hơn bảy baseline (Bảng 1), và giảm chất lượng êm hơn khi số thành phần bị giới hạn.
Đóng góp chính gồm hỗn hợp phân phối t, các thành phần có dấu (dương và âm) và cơ chế lấy mẫu để học chúng.
SSS xem 3DGS là một mô hình hỗn hợp chưa chuẩn hóa và đặt câu hỏi với ba lựa chọn thiết kế: kernel Gaussian, hỗn hợp chỉ cộng (đơn điệu) và tối ưu kiểu Adam cho các tham số ghép chặt. Bài thay bằng kernel Student's t với bậc tự do học được, opacity trong [-1, 1], và stochastic gradient Hamiltonian Monte Carlo (SGHMC) trên tâm các thành phần kèm bước tái chế thành phần.
Khảo sát thực nghiệm gồm 11 cảnh (Mip-NeRF 360, Tanks and Temples, Deep Blending) so với Mip-NeRF, 3DGS, GES, 3DHGS, Fre-GS, Scaffold-GS và 3DGS-MCMC, cộng thêm quét theo số thành phần tối đa (năm mức) và ablation. Bài ghi nhận nguồn tài trợ từ chương trình EU Horizon 2020 (grant 899739, CrowdDNA).
Bài toán nghiên cứu
Các phương pháp dựng cảnh 3D phổ biến cần hàng triệu đốm, gây lãng phí bộ nhớ. Mỗi đốm có một hình mờ cố định, và đốm chỉ có thể chồng lên nhau. Muốn khoét một lỗ giữa vật thể, phải dùng rất nhiều đốm chỉ để giả lập cái lỗ đó.
Tác giả chỉ ra hai điểm yếu của 3DGS: khả năng biểu diễn hạn chế và hiệu quả tham số thấp, tức cần nhiều thành phần. Gaussian có hình dạng đuôi cố định nên biểu diễn các cấu trúc rất khác nhau cần nhiều đốm.
Họ xem lại ba phần của công thức 3DGS: kernel Gaussian, việc splatting chỉ cộng mật độ, và việc tối ưu. Bài toán vẫn là bài chuẩn: đầu vào là tập ảnh có camera đã biết cùng đám mây điểm thưa từ structure-from-motion (SfM); đầu ra là mô hình render được góc nhìn chưa thấy. Câu hỏi là làm sao đạt chất lượng với ngân sách thành phần nhỏ hơn.
3DGS ghép cảnh bằng tổng có trọng số các Gaussian 3D với tâm, hiệp phương sai (xoay nhân tỉ lệ), opacity trong [0, 1] và màu phụ thuộc hướng nhìn qua spherical harmonics, render bằng chiếu xuống 2D rồi cộng gộp từ trước ra sau. Theo cách nhìn của bài, đây là hỗn hợp 3D được khớp vào radiance field, trong đó mỗi trọng số còn phụ thuộc các thành phần khác qua tích compositing.
Bài nêu ba nút thắt: kernel kém biểu diễn, hỗn hợp không âm, và bộ tối ưu yếu khi tham số ghép chặt. Lập luận ghép tham số khá cụ thể: đổi tham số đuôi là đổi họ phân phối mà tâm và hiệp phương sai đang được tối ưu bên trong, nên các tham số này không thể xử lý độc lập. Vì vậy câu hỏi đánh giá là chất lượng ở ngân sách thành phần cố định, chứ không chỉ chất lượng khi để density control tự do.
Ý tưởng chính
Hai thay đổi. Thứ nhất, dùng đốm có độ dày mép chỉnh được, từ đuôi rất dày đến hình chuông quen thuộc. Thứ hai, cho một số đốm lấy bớt màu thay vì thêm màu. Rồi huấn luyện bằng cách chủ động thêm chút ngẫu nhiên để đốm thoát khỏi vị trí xấu.
Khẩu hiệu của bài là mô hình cần "không phải Gaussian cũng không phải splatting". Mỗi thành phần là phân phối Student's t nhiều chiều có bậc tự do học được. Giá trị thấp cho đuôi dày (gần Cauchy), giá trị cao tiến tới Gaussian, nên một họ phân phối phủ cả dải hình dạng.
Ý tưởng thứ hai là scooping: thành phần có thể mang opacity âm và trừ bớt màu. Trong ví dụ hình xuyến, chỉ dùng thành phần dương cần ít nhất năm thành phần để dựng đúng cái lỗ, trong khi một thành phần dương và một âm, cùng đặt ở tâm, là đủ.
Ý tưởng thứ ba là học bằng lấy mẫu. Vì trọng số có dấu làm hỗn hợp không còn là mật độ đúng nghĩa, tác giả viết một hàm năng lượng từ loss render rồi chạy SGHMC, phương pháp Monte Carlo có momentum, ma sát và nhiễu.
Kernel là $[1+\frac{1}{\nu}(x-\mu)^T\Sigma^{-1}(x-\mu)]^{-(\nu+3)/2}$, bỏ hằng số chuẩn hóa; sau khi chiếu, kernel 2D có cùng dạng với số mũ $-(\nu+2)/2$, nhờ vậy lượt xuôi và ngược có dạng đóng (khác GES, mà tác giả cho là cần xấp xỉ). Thực tế $\nu$ bị giới hạn trong [1, 10000].
Trọng số có dấu vẫn tuyến tính theo thành phần. Tác giả cũng thử hỗn hợp bình phương của Loconte và cộng sự, có tương tác từng cặp tốn $O(n^2)$ làm chậm đáng kể, nên bỏ. Việc học được đặt thành lấy mẫu từ phân phối tỉ lệ với $\exp(-\text{loss}-\frac12 r^Tr)$ trên tham số và momentum, trong đó ma sát nhằm tách $\nu$ khỏi tâm và hiệp phương sai. Phụ lục cho thấy $\nu$ học được trải rộng khi dùng SGHMC nhưng tập trung gần 1 khi tối ưu kiểu 3DGS, điều tác giả diễn giải là mode collapse.
Phương pháp
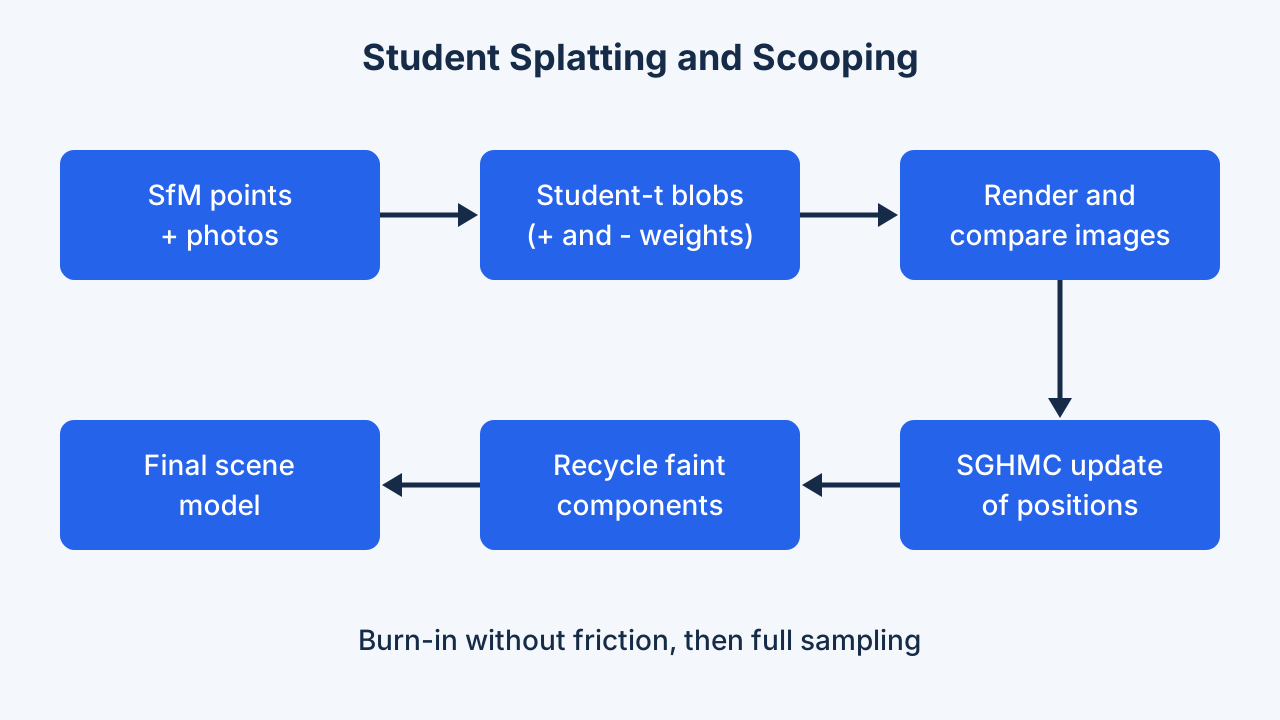
Bắt đầu từ các điểm của một lần dựng lại từ ảnh. Mỗi điểm cho một đốm. Render các đốm, so với ảnh thật rồi chỉnh. Đốm mờ được chuyển sang chỗ hữu ích thay vì bỏ đi. Có thêm chút ngẫu nhiên có chủ ý, giai đoạn đầu không phanh, để đốm khám phá trước khi ổn định.
Đầu vào là tập ảnh với tư thế camera và đám mây điểm SfM thưa. Mỗi điểm khởi tạo một thành phần Student's t gồm tâm, tỉ lệ, góc xoay, màu spherical harmonics, opacity trong [-1, 1] (giữ trong biên bằng tanh) và bậc tự do. Render chiếu các thành phần xuống 2D và cộng gộp từ trước ra sau với trọng số có dấu.
Loss theo 3DGS-MCMC: kết hợp lỗi ảnh L1 và D-SSIM, cộng hai điều chuẩn, một phạt opacity để thành phần chỉ lớn khi thật cần, một phạt trị riêng hiệp phương sai để thành phần giữ nhỏ. Tâm thành phần được cập nhật bằng SGHMC, các tham số còn lại dùng Adam.
Huấn luyện bắt đầu bằng burn-in không ma sát để khám phá, sau đó lấy mẫu đầy đủ. Thay cho clone-and-split, thành phần gần trong suốt được chuyển lên các thành phần opacity cao theo cách giữ ảnh render gần như không đổi; mỗi lần chuyển tối đa 5% thành phần, và thêm 5% thành phần mới opacity bằng không.
Một cổng sigmoid (độ dốc 100, ngưỡng 0,995) bật ma sát và nhiễu chủ yếu cho thành phần gần trong suốt. Cập nhật SGHMC của tâm gồm bước gradient nhân bình phương learning rate, một số hạng ma sát và nhiễu Gaussian gắn với ma sát, với bước giảm dần; bỏ ma sát thì thành stochastic gradient Langevin dynamics (SGLD). Trong burn-in nhiễu được nhân hiệp phương sai để giữ tính dị hướng; sau đó momentum giữ nó. Tác giả báo cáo SGLD khám phá rộng còn SGHMC khai thác cục bộ tốt hơn. Lưu ý văn bản nói cổng bật khi opacity dưới 0,005, còn công thức in với ngưỡng 0,995 đọc ngược lại; chúng tôi theo văn bản và đánh dấu điểm mơ hồ này.
Việc chuyển thành phần cực tiểu tích phân bình phương sai khác màu trên toàn miền. Thành phần di chuyển lấy tâm đích; opacity mới thỏa $(1-o_{new})^N = 1-o_{old}$ cho $N$ thành phần đồng vị trí; hiệp phương sai được nhân hệ số dạng đóng chứa hàm Beta (cài đặt qua log-Gamma cho CUDA). Dấu bị bỏ qua khi chuyển, tác giả cho là một nhiễu hữu ích. Ứng viên được rút từ phân phối đa thức theo opacity.
Ghi chú cài đặt từ phụ lục: bộ lọc thông thấp 0,3 của 3DGS bị bỏ ở mô hình cuối vì phân phối t không đóng dưới tích chập (chỉ giữ ở baseline SGD trong ablation); bán kính cắt cho thành phần chiếu dùng giá trị tới hạn tra bảng nội suy theo $\nu$; và bài không in số vòng lặp hay tỉ lệ thành phần âm, các giá trị đó nằm trong file cấu hình của kho mã. Thí nghiệm chạy trên một RTX 4090.
Thực nghiệm & kết quả
| Phương pháp | Mip-NeRF 360 PSNR | Mip-NeRF 360 SSIM | Mip-NeRF 360 LPIPS | Tanks&Temples PSNR | Tanks&Temples SSIM | Tanks&Temples LPIPS |
|---|---|---|---|---|---|---|
| Mip-NeRF | 29.23 | 0.844 | 0.207 | 22.22 | 0.759 | 0.257 |
| 3DGS | 28.69 | 0.870 | 0.182 | 23.14 | 0.841 | 0.183 |
| GES | 26.91 | 0.794 | 0.250 | 23.35 | 0.836 | 0.198 |
| 3DHGS | 29.56 | 0.873 | 0.178 | 24.49 | 0.857 | 0.169 |
| Fre-GS | 27.85 | 0.826 | 0.209 | 23.96 | 0.841 | 0.183 |
| Scaffold-GS | 28.84 | 0.848 | 0.220 | 23.96 | 0.853 | 0.177 |
| 3DGS-MCMC | 29.89 | 0.900 | 0.190 | 24.29 | 0.860 | 0.190 |
| SSS (ours) | 29.90 | 0.893 | 0.145 | 24.87 | 0.873 | 0.138 |
| Phương pháp | Deep Blending PSNR | Deep Blending SSIM | Deep Blending LPIPS |
|---|---|---|---|
| Mip-NeRF | 29.40 | 0.901 | 0.245 |
| 3DGS | 29.41 | 0.903 | 0.243 |
| GES | 29.68 | 0.901 | 0.252 |
| 3DHGS | 29.76 | 0.905 | 0.242 |
| Fre-GS | 29.93 | 0.904 | 0.240 |
| Scaffold-GS | 30.21 | 0.906 | 0.254 |
| 3DGS-MCMC | 29.67 | 0.890 | 0.320 |
| SSS (ours) | 30.07 | 0.907 | 0.247 |
| Phương pháp | δ | 1.4δ | 1.8δ | 2.2δ | 2.6δ |
|---|---|---|---|---|---|
| 3DGS | 19.16 | 20.32 | 20.50 | 21.22 | 21.75 |
| GES | 20.59 | 21.60 | 22.78 | 23.52 | 23.86 |
| 3DHGS | 19.63 | 20.33 | 20.39 | 20.99 | 22.12 |
| 3DGS-MCMC | 27.47 | 27.89 | 28.18 | 28.39 | 28.56 |
| SSS (ours) | 27.72 | 28.14 | 28.43 | 28.66 | 28.84 |
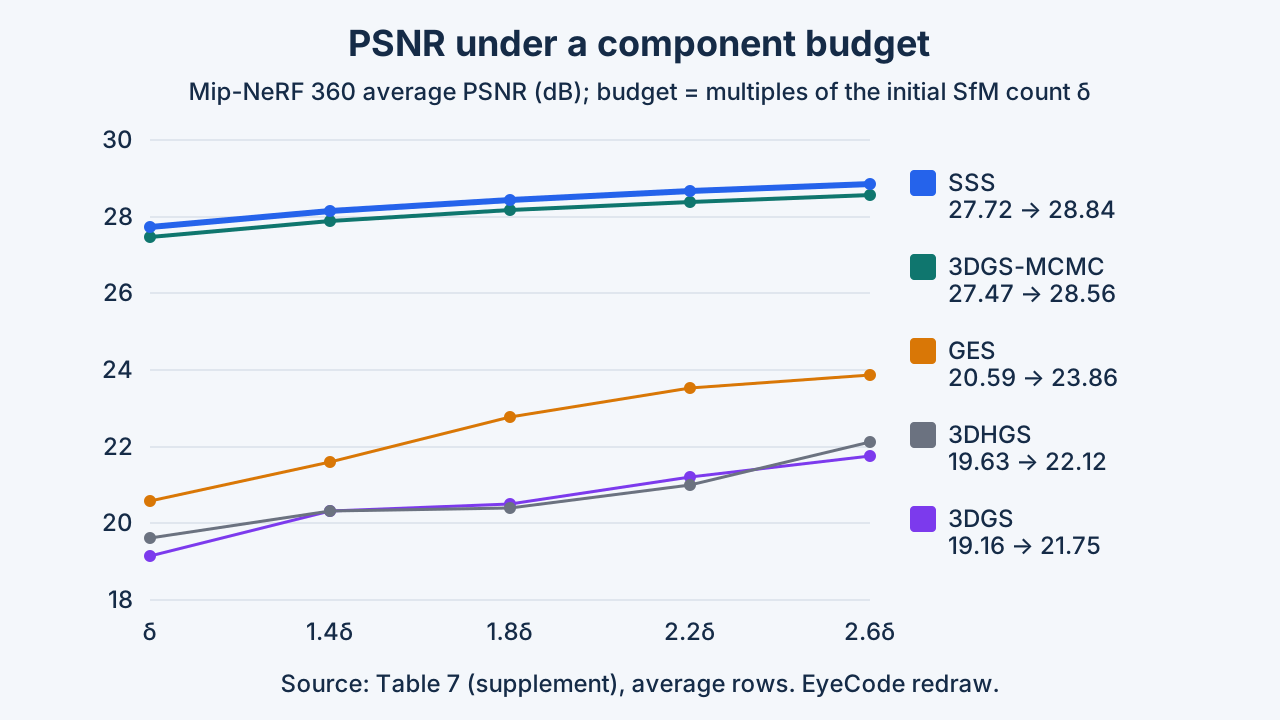
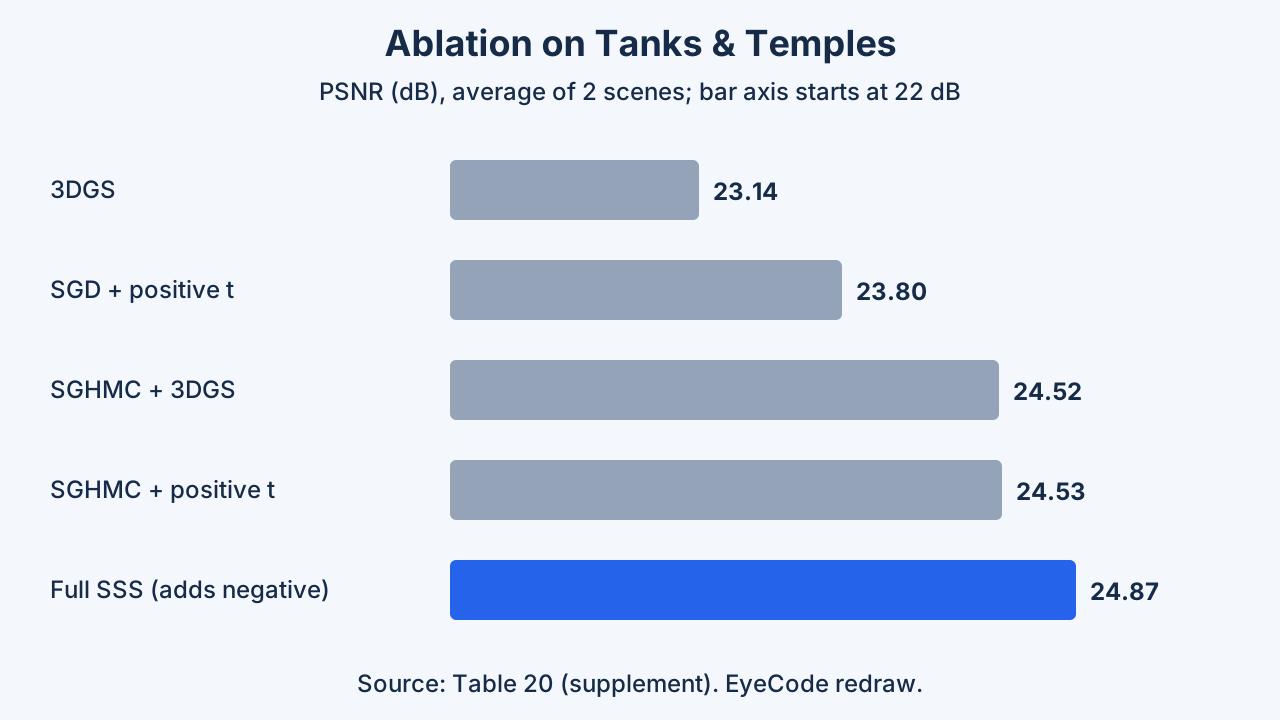
Trên ba bộ cảnh chuẩn, phương pháp mới ngang hoặc nhỉnh hơn các đối thủ mạnh, và rõ ràng tốt hơn ở thước đo tương đồng cảm nhận trong vài trường hợp. Khi chỉ cho phép ít đốm, nó giữ chất lượng tốt hơn hẳn cách cũ. Đổi lại nó huấn luyện chậm hơn 3DGS.
Thiết lập: 11 cảnh (7 Mip-NeRF 360, 2 Tanks and Temples, 2 Deep Blending), thước đo PSNR, SSIM và LPIPS. Ở Bảng 1, số của baseline lấy từ bài gốc còn SSS là trung bình ba lần chạy; các bảng chung bên dưới chép lại chúng. Tác giả nêu SSS tốt nhất ở 6 trên 9 chỉ số và nhì ở 2.
So với 3DGS gốc, SSS hơn khoảng 1,2 dB trên Mip-NeRF 360 (29,90 so với 28,69) và 1,7 dB trên Tanks and Temples (24,87 so với 23,14), LPIPS cũng thấp hơn ở cả hai. So với 3DGS-MCMC thì sát hơn: PSNR gần bằng nhau trên Mip-NeRF 360, SSIM thấp hơn, LPIPS tốt hơn rõ.
Hiệu quả tham số: baseline được chạy lại với giới hạn số thành phần, từ số điểm SfM ban đầu đến 2,6 lần. SSS dẫn đầu PSNR ở 15 trên 15 thiết lập. Trên Mip-NeRF 360 nó giữ 27,72 dB ở ngân sách nhỏ nhất, trong khi 3DGS bị giới hạn rơi xuống 19,16 (Bảng 3 bên dưới).
Ablation trên Tanks and Temples (Hình 2 của bài viết này): 3DGS 23,14 dB, SGD với t dương 23,80, SGHMC với t dương 24,53, mô hình đủ với thành phần âm 24,87. Huấn luyện lâu hơn 3DGS (45 so với 21 phút trên Mip-NeRF 360), render 71 so với 99 FPS.
Giao thức. Bảng 1 trộn nguồn (số baseline đã công bố so với trung bình ba lần chạy của SSS). Với quét ngân sách, tác giả sửa densification của baseline để dừng ở mức giới hạn, không chỉnh siêu tham số khác, nên mức tụt lớn của 3DGS, GES và 3DHGS một phần phản ánh việc ép các phương pháp này vào ngân sách chúng không được thiết kế cho. Đối thủ sát nhất là 3DGS-MCMC, vốn hỗ trợ giới hạn sẵn: trên Mip-NeRF 360 SSS dẫn khoảng 0,25-0,3 dB PSNR ở mọi ngân sách, nhưng 3DGS-MCMC có SSIM bằng hoặc nhỉnh hơn (0,803 so với 0,802 ở ngân sách nhỏ nhất). Khoảng cách lớn hơn ở Tanks and Temples (23,67 so với 23,18 ở ngân sách nhỏ nhất, 24,40 so với 23,93 ở 2,6 lần) và Deep Blending (28,69 so với 28,38; 29,67 so với 29,35).
Theo từng cảnh, 3DGS-MCMC thắng PSNR ở bicycle và stump (Mip-NeRF 360, Bảng 1 phụ lục: 26,15 so với 25,68 và 27,80 so với 27,17). Tóm tắt và Mục 4.3 nêu mức giảm tới 82%, trong khi Mục 4.3 cũng nêu 98,3% là mức tối đa (Stump, 83k trên 4,75 triệu) khi so ngân sách 2,6 lần với số thành phần gốc của 3DGS; từ các số đã in, chúng tôi tính được 57,5% cho Train (468k trên 1,1 triệu) và 86% cho Truck (364k trên 2,6 triệu). Như vậy con số 82% không tái lập được từ số đã in và nên được đọc là xấp xỉ.
Đọc ablation (Bảng 20 phụ lục, PSNR Tanks and Temples / Deep Blending): SGHMC với Gaussian thường đã đạt 24,52 / 29,56, gần bằng SGHMC với t dương (24,53 / 29,75), và kernel t thậm chí làm SSIM và LPIPS tệ đi trên Tanks and Temples (0,864 / 0,155 so với 0,869 / 0,150). Tác giả nhận xét từng kỹ thuật chỉ cho cải thiện nhỏ và mô hình đủ là tốt nhất. Thành phần âm thêm 0,34 và 0,32 dB. Trên Deep Blending, LPIPS của mô hình đủ bằng SGD (0,247). Thời gian (Bảng 21): SSS 45, 33 và 21 phút huấn luyện, 71, 87 và 100 FPS trên Mip-NeRF 360, Tanks and Temples và Deep Blending; 3DGS 21, 12, 21 phút.
Định tính. Tác giả cho các vùng phóng to nơi SSS khôi phục vết lõm nắp hộp, cửa sổ, chi tiết đường ray xanh, phản chiếu trên kính xe tải và công tắc đèn (Hình 3 của bài), và với cảnh Train ở ngân sách khoảng 180k đến 468k thành phần thì 3DGS và 3DHGS bị mờ, GES làm mờ ranh giới trời-đồi, 3DGS-MCMC thêm các mảng trắng trên trời, còn SSS tách trời và đồi mà không nhiễu. Trong phụ lục, kết cấu thảm ở room và khe cửa sổ ở drjohnson được SSS khôi phục tốt hơn 3DGS-MCMC. Đây là các ví dụ do tác giả chọn, không phải nghiên cứu về ca thất bại.
Hạn chế
Đốm vẫn mềm và đối xứng, và cách huấn luyện cần chỉnh kỹ, ví dụ bao nhiêu đốm nên là đốm trừ. Vẫn có thể xuất hiện vật thể lơ lửng, và huấn luyện lâu hơn trước.
Do tác giả nêu
- Các primitive bị giới hạn ở phân phối t đối xứng và mượt, hạn chế khả năng biểu diễn, và hình sắc cạnh khó xử lý hoàn hảo.
- Bộ lấy mẫu cần tinh chỉnh siêu tham số, ví dụ phần trăm thành phần âm.
- Dù SGHMC khám phá nhiều hơn, vẫn đôi khi xuất hiện floating artifact, vấn đề phổ biến của 3DGS.
- Hướng tương lai họ nêu: kết hợp các họ phân phối khác như Laplace với phân phối t, và làm SGHMC tự thích nghi để cân bằng thành phần dương và âm.
Phân tích của EyeCode (diễn giải biên tập)
- Bài không có mục hạn chế riêng; các điểm trên nằm ở phần kết luận và phụ lục.
- Các bảng cho thấy chi phí mà tác giả chỉ nhắc ngắn: huấn luyện chậm hơn 3DGS và 3DGS-MCMC, render cũng chậm hơn (SSS 71 FPS so với 99 và 79 trên Mip-NeRF 360; Bảng 21).
- README chính thức nói viewer 3DGS thông thường không hiển thị được đầu ra của SSS.
Do tác giả nêu
- Primitive đối xứng, mượt (kết luận, Mục 7 phụ lục); hình sắc cạnh khó.
- Cần tinh chỉnh bộ lấy mẫu, gồm phần trăm thành phần âm; README bổ sung rằng các tham số ma sát tương quan mạnh với kết quả và giá trị lớn có thể gây lỗi số (inf hoặc NaN).
- Floating artifact vẫn có thể còn.
Phân tích của EyeCode (diễn giải biên tập)
- Giao thức không đồng nhất: số baseline lấy từ bài gốc còn SSS là trung bình ba lần chạy; baseline giới hạn ngân sách do tác giả sửa, nên chênh lệch tuyệt đối với 3DGS, GES và 3DHGS phụ thuộc cách chỉnh đó. So sánh công bằng nhất là với 3DGS-MCMC, nơi mức hơn PSNR vào khoảng 0,25-0,5 dB và không đồng đều giữa các chỉ số.
- Ablation cho thấy phần lớn mức tăng so với SGD đến từ bộ lấy mẫu, còn riêng kernel t thêm ít PSNR trên Tanks and Temples; vì vậy lợi ích của họ phân phối mới chưa được tách bạch ở đó.
- Các số in có điểm không nhất quán: con số 82% (xem phần Kết quả), PSNR/SSIM/LPIPS của SSS ở Train là 23,23/0,844/0,170 trong văn bản nhưng 23,32/0,850/0,166 trong phụ lục (phụ lục khớp với trung bình 24,87 đã in), LPIPS Garden của SSS là 0,009 trong phụ lục, và một ô LPIPS của 3DGS-MCMC ghi 0,860 trong khi Bảng 1 ghi 0,190. Nên dùng thận trọng các số trong văn bản và ưu tiên bảng chính.
- Nhiều thiết lập ảnh hưởng tái lập, như số vòng lặp và độ dài burn-in, chỉ có trong mã nguồn.
Điểm cần nhớ
Đổi hình dạng đốm, cho một số đốm trừ bớt, và huấn luyện bằng bộ tối ưu thông minh có nhiễu, cùng nhau cho ảnh tốt với ít đốm hơn nhiều so với cách cũ.
- Kernel Student's t có đuôi học được tổng quát hóa Gaussian.
- Thành phần có dấu cho phép hỗn hợp khoét bớt mật độ, như ví dụ hình xuyến.
- So sánh phương pháp ở ngân sách thành phần cố định, không chỉ khi density control tự do.
- Trong ablation của bài, bộ lấy mẫu mang lại mức tăng đơn lẻ lớn nhất so với huấn luyện SGD.
- Cái giá là huấn luyện lâu hơn và thêm việc tinh chỉnh.
Hướng gợi ý (đề xuất của EyeCode, không phải kết luận của bài báo)
- Thử từng thành phần riêng lẻ trong một codebase splatting khác, ví dụ chỉ dùng bộ lấy mẫu.
- Hãy đọc SSS như ba thành phần tách được với lợi ích khác nhau: bộ lấy mẫu quan trọng nhất trong ablation đã báo cáo, thành phần âm thêm mức tăng nhỏ đều (khoảng 0,3 dB), và kernel t rõ nhất ở ngân sách nhỏ.
- Tham số ghép chặt là lý do nên xem các bộ tối ưu có momentum và ma sát, không chỉ kernel.
- Kiểm tra chi tiết giao thức: baseline bị giới hạn, trung bình ba lần chạy, và lỗi in trong bảng phụ lục.
Hướng gợi ý (đề xuất của EyeCode, không phải kết luận của bài báo)
- Chạy ablation ở số thành phần bằng nhau để tách kernel khỏi bộ lấy mẫu trên nhiều bộ dữ liệu hơn.
- Đo bộ nhớ và tốc độ render ở chất lượng ngang nhau, vì bài báo cáo chất lượng ở số thành phần ngang nhau.