
NitroGen: An Open Foundation Model for Generalist Gaming Agents
NitroGen nghiên cứu agent thị giác–hành động có thể chơi nhiều trò chơi. Dữ liệu hành động được trích từ video gameplay, kết hợp behavior cloning và môi trường đánh giá đa trò chơi để khảo sát khả năng chuyển giao sang trò chơi mới.
NitroGen là mô hình nền tảng thị giác-hành động mở cho agent chơi game, phát hành cùng dataset video có nhãn hành động và benchmark 30 tác vụ trên 10 game. Bài phân tích này giải thích cách khai thác nhãn từ video, cách policy hoạt động, các con số cho thấy điều gì và bài báo không kiểm tra điều gì.
Tổng quan
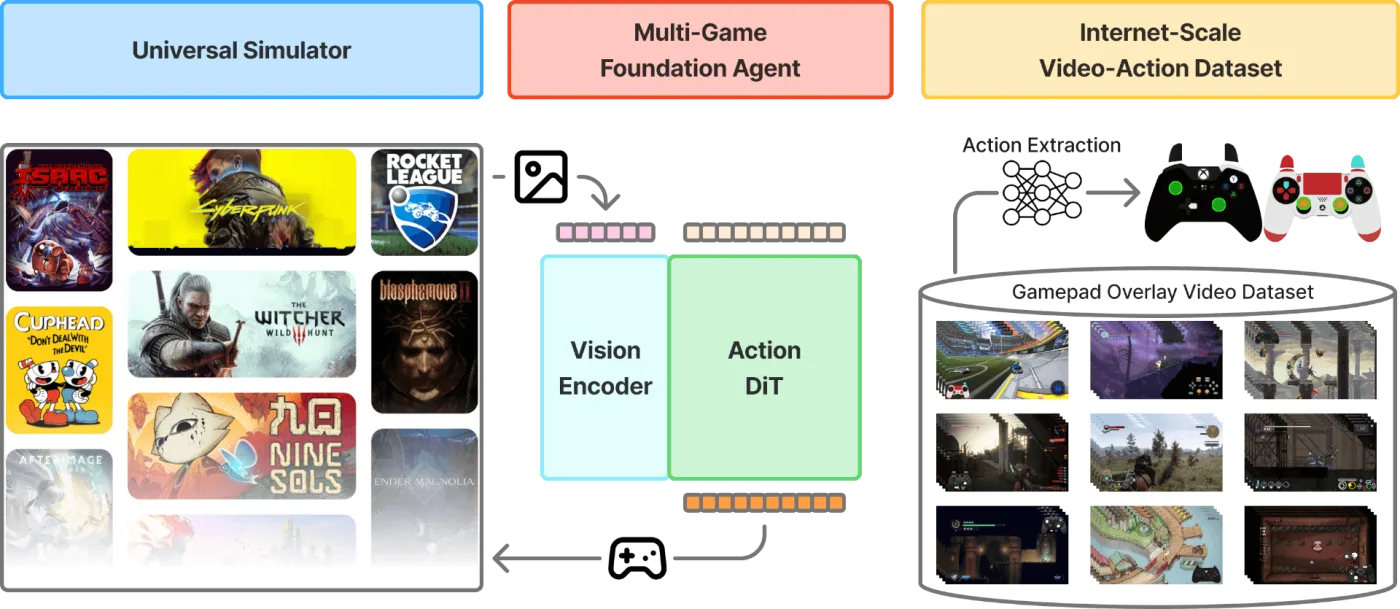
NitroGen là chương trình học chơi game bằng cách xem người khác chơi. Thầy của nó là các video gameplay có vẽ tay cầm điều khiển ngay trên màn hình, nên chương trình thấy được nút nào đang được bấm. Sau khi xem rất nhiều video như vậy, nó có thể điều khiển nhiều game khác nhau bằng tay cầm, và học một game hoàn toàn mới nhanh hơn chương trình bắt đầu từ con số không.
NitroGen (Magne và cộng sự, từ NVIDIA cùng Stanford, Caltech, UChicago và UT Austin) là mô hình nền tảng thị giác-hành động cho agent chơi game. Mô hình được huấn luyện bằng behavior cloning, tức bắt chước người chơi đã được ghi lại, trên 40.000 giờ video gameplay của hơn 1.000 game. Bài báo phát hành ba thứ: một dataset video có nhãn hành động, một bộ đánh giá gồm 30 tác vụ trên 10 game thương mại với wrapper kiểu Gymnasium, và mô hình đã pretrain.
Kết luận chính là fine-tune từ mô hình pretrain tốt hơn huấn luyện cùng kiến trúc từ đầu trên các game bị giữ lại, tối đa 52% tương đối với 30 giờ dữ liệu fine-tune ở một game. Theo trang Best Papers chính thức, bài nhận CVPR 2026 Best Paper Honorable Mention; các nhận xét đánh giá trong bài viết này là của biên tập.
Embodied AI thiếu dữ liệu quy mô internet có nhãn hành động như đã thúc đẩy các mô hình thị giác và ngôn ngữ. NitroGen giải quyết nút thắt này bằng ba đóng góp: (1) dataset xây dựng bằng cách đọc hành động từ input overlay mà người sáng tạo nội dung hiển thị trên video gameplay; (2) một universal simulator bọc game thương mại bằng API Gymnasium, kèm benchmark 30 tác vụ trên 10 game; (3) một transformer thị giác-hành động dùng flow matching, huấn luyện bằng behavior cloning trên dataset.
Các tác giả gọi đây là dataset video-hành động có nhãn lớn nhất cho video game. Công trình liên quan họ nêu: VPT gán nhãn 70.000 giờ Minecraft bằng inverse dynamics, và Game-TARS (đồng thời) huấn luyện trên 20.000 giờ kết hợp dữ liệu contractor với dữ liệu lập luận đa phương thức. Thiết lập ở đây cố ý hẹp: một khung RGB vào, hành động gamepad ra, không có ngôn ngữ, nên nghiên cứu cô lập được phần đóng góp của pretraining hành động. Ghi nhận chính thức là Honorable Mention do CVPR 2026 công bố; mọi điều còn lại là diễn giải của biên tập.
Bài toán nghiên cứu
Để dạy một chương trình chơi game, cần rất nhiều ví dụ gồm màn hình và các nút người chơi đã bấm. Những bộ sưu tập như vậy hiếm và nhỏ. Các bot chơi game trước đây thường chỉ được huấn luyện cho đúng một game, vừa chậm vừa tốn kém, nên mỗi bot chỉ giỏi một việc.
Agent hiện thân thiếu dữ liệu quy mô internet có nhãn hành động như đã giúp mô hình ngôn ngữ và thị giác. Các hướng trước đây còn hẹp: học tăng cường mạnh trong từng game nhưng tốn kém, agent LLM cần giao diện tự viết, còn behavior cloning từ pixel dựa vào demonstration đắt đỏ nên chỉ phủ vài tựa game.
Bài toán gồm ba phần. Dữ liệu: lấy nhãn hành động ở quy mô internet mà không trả tiền người ghi hình. Đánh giá: đo tổng quát hóa giữa các game khác nhau. Mô hình: ánh xạ một khung hình sang hành động gamepad bằng một policy duy nhất và kiểm tra pretraining có giúp ích trên game chưa thấy với cùng ngân sách dữ liệu và tính toán hay không.
Về hình thức, policy nhìn một khung RGB 256 x 256 và xuất một chunk gồm 16 hành động gamepad tương lai trong không gian hành động chung cho mọi game. Không có mục tiêu ngôn ngữ, không có trạng thái cảm biến và không có lịch sử ngoài khung đó; các tác giả báo cáo thêm khung quá khứ không có lợi, kể cả khi tăng khoảng cách thời gian, và giải thích là trạng thái đầu của các game hành động này đã đủ ngữ cảnh.
Vì sao các hướng trước chưa đủ, theo cách đặt vấn đề của tác giả: agent LLM cần API lập trình hoặc module perception phức tạp; học tăng cường (StarCraft II, Dota 2) hẹp và cần simulator hiếm có cho game bất kỳ; dataset behavior cloning như MineRL hay VPT chỉ phủ một hoặc vài game. Họ cũng nhấn mạnh chưa có framework mở để huấn luyện và đánh giá agent chơi game tổng quát.
- Thách thức dữ liệu: overlay khác nhau về loại controller, độ trong suốt và nén video, và bản ghi hiếm khi kèm input của người chơi.
- Thách thức đánh giá: game thương mại không có giao diện lập trình và cơ chế rất khác nhau.
- Thách thức mô hình: nhãn không phải ground truth, nên policy phải chịu được nhiễu.
Ý tưởng chính
Một số người chơi hiện hình tay cầm ở góc video, nút nào bấm thì sáng lên. NitroGen đọc hình đó từng khung và biến video thành bài học: với màn hình này, hãy bấm các nút này. Sau đó nó che hình tay cầm đi để người học phải dựa vào chính game.
Ý tưởng trung tâm là dùng các video mà người sáng tạo hiển thị input overlay, một hình tay cầm 2D nhỏ với các nút đang bấm được làm nổi bật. Pipeline ba giai đoạn tìm overlay, đọc joystick và nút từng khung rồi lọc, cho ra nhãn cho hàng chục nghìn giờ. Một policy tổng quát được huấn luyện trên toàn bộ dữ liệu, rồi kiểm tra bằng fine-tune trên game bị giữ ngoài pretraining.
Ví dụ nhỏ: overlay cho thấy cần analog đang đẩy lên và nút A sáng; nhãn của khung đó là hai input này, và mô hình học tạo ra chúng chỉ từ hình ảnh game.
Ba lựa chọn thiết kế làm nên bài báo.
- Giám sát yếu từ overlay: kết quả đọc trực quan của controller được dùng làm nhãn, đánh đổi độ chính xác lấy quy mô. Phần mềm overlay gây trễ nhỏ và việc parse thêm sai số, nên nhãn có nhiễu.
- Một không gian hành động chung: 16 nút nhị phân (4 d-pad, 4 nút mặt, 2 shoulder, 2 trigger, 2 lần nhấn cần analog, start, back) cộng 4 giá trị joystick liên tục, giống nhau cho mọi game, khác với không gian hành động riêng cho từng game trước đây.
- Một simulator phổ quát: wrapper Gymnasium chặn đồng hồ hệ thống của game để tiến game từng khung trong lúc mô hình suy nghĩ, không sửa mã game.
Khác biệt so với công trình trước: VPT khôi phục nhãn bằng mô hình inverse dynamics trên một game (Minecraft); NitroGen lấy nhãn từ việc đọc trực quan trên hơn 1.000 game. NitroGen cũng bỏ điều kiện ngôn ngữ, khác với các mô hình vision-language-action cho robot.
Phương pháp
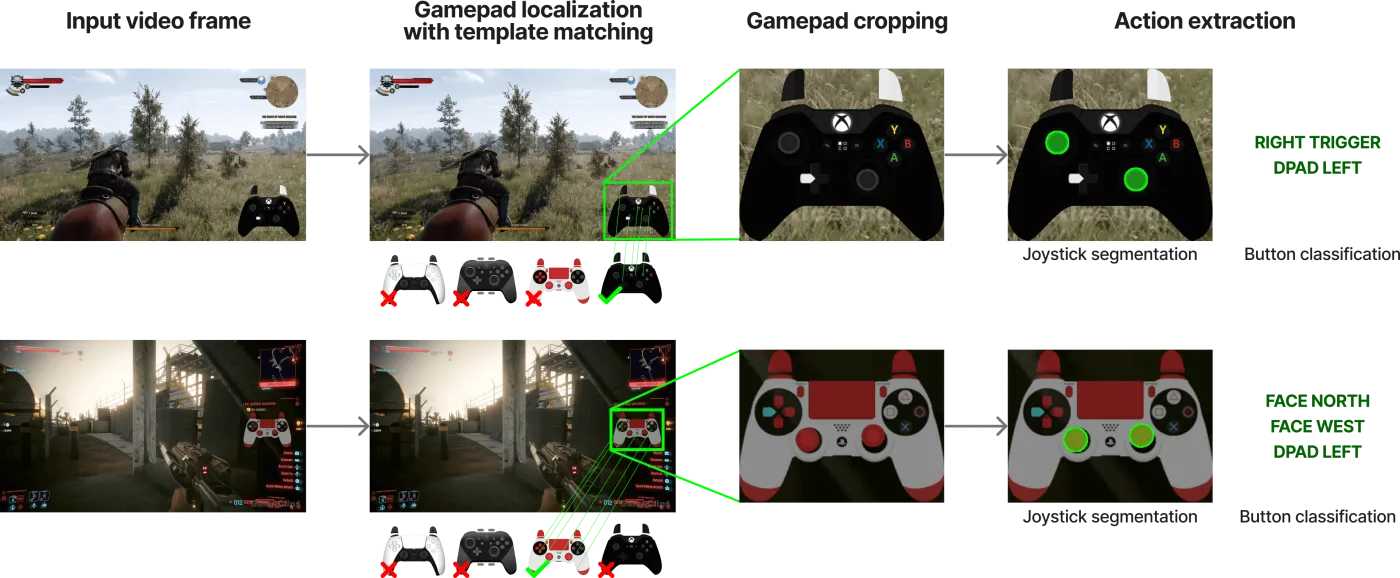
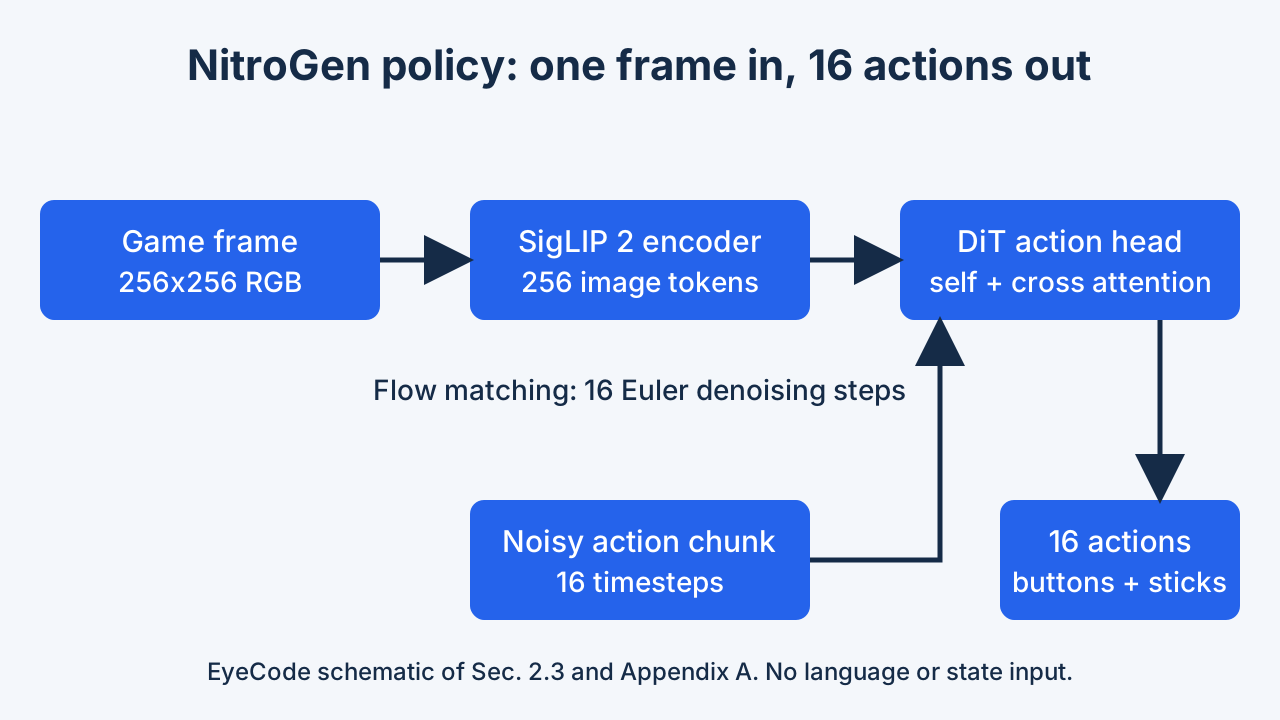
Bước một, tìm video có tay cầm hiển thị. Bước hai, đọc tay cầm để có nhãn nút bấm. Bước ba, dạy mạng nơ-ron đoán vài lần bấm nút tiếp theo từ hình màn hình hiện tại. Bước bốn, cho nó chơi trong một lớp bọc tạm dừng game khi nó đang suy nghĩ.
Pipeline dữ liệu. Tác giả thu 71.000 giờ video thô có overlay; sau khi lọc, dataset còn 40.000 giờ, từ 38.739 video của 818 người sáng tạo. Giai đoạn 1 so khớp 25 khung mỗi video với khoảng 300 template controller bằng đặc trưng SIFT và XFeat. Giai đoạn 2 đưa hai khung liên tiếp vào SegFormer đã fine-tune, xuất vị trí joystick trên lưới 11 x 11 và trạng thái nút nhị phân. Giai đoạn 3 chỉ giữ chunk mà ít nhất một nửa số bước có hành động khác không, giữ lại 55% dữ liệu, và che controller trên màn hình.
Policy. Thiết kế được điều chỉnh từ GR00T N1, bỏ bộ mã hóa ngôn ngữ và trạng thái. Một SigLIP 2 vision transformer biến một khung 256 x 256 thành 256 token. Một diffusion transformer với các lớp self-attention và cross-attention tới các token đó khử nhiễu một chunk 16 hành động bằng conditional flow matching và 16 bước Euler. Mô hình có khoảng 500M tham số. Theo tác giả, dự đoán theo chunk nhất quán theo thời gian hơn dự đoán từng hành động (không kèm số).
Huấn luyện parser. SegFormer được huấn luyện trên 8M khung tổng hợp, tạo bằng cách chồng template controller của ba chương trình overlay lên các khung của dataset với trạng thái nút và vị trí joystick ngẫu nhiên, thay đổi độ trong suốt, kích thước và nén. Optimizer AdamW, learning rate 0,0001 giảm tuyến tính, weight decay 0,1, batch 256. Joystick được dự đoán bằng segmentation trên lưới rời rạc, mà tác giả thấy tốt hơn đáng kể so với hồi quy tọa độ. Lúc suy luận, tâm joystick được ước lượng từ các khung được phân loại là ở giữa và vị trí được chuẩn hóa về [-1, 1] bằng phân vị 99 của giá trị tuyệt đối trong mỗi video.
Huấn luyện policy. Với chunk hành động $a$ (16 bước), quan sát $o$, nhiễu $\varepsilon$ và thời gian flow $t$, hành động nhiễu là $a_t=(1-t)a+t\varepsilon$ và DiT được huấn luyện dự đoán vận tốc $\varepsilon-a$ bằng sai số bình phương; $t$ lấy từ phân phối beta dịch, ưu tiên các bước thời gian nhỏ. Lúc suy luận bắt đầu từ nhiễu Gauss và chạy $k=16$ bước Euler; thêm bước không cải thiện đo được. Chunk hành động nhiễu đi qua MLP thành một token mỗi bước thời gian, rồi qua các khối DiT, và một MLP giải mã từng token độc lập theo thời gian.
- Augmentation: độ sáng, tương phản, bão hòa, sắc độ, xoay trong 5 độ, random crop.
- AdamW với weight decay 0,001; lịch warmup-stable-decay với learning rate không đổi 0,0001; EMA của trọng số với decay 0,9999, và mọi kết quả dùng trọng số EMA, mà tác giả nói luôn tốt hơn bản không EMA.
- Ngân sách tính toán và thời gian huấn luyện của mô hình pretrain không được nêu trong văn bản bài báo.
Số chiều của không gian hành động. Văn bản Mục 2.2 nêu 16 nút nhị phân cộng 4 giá trị joystick liên tục (20 số mỗi bước), trong khi Phụ lục A viết chunk hành động thuộc không gian 16 x 24, và model card trên Hugging Face mô tả đầu ra 21 x 16 (hai vector joystick 2D và 17 nút nhị phân). Số 16 khớp với độ dài chunk ở cả ba nơi; số chiều mỗi bước thì khác (20, 24, 21). Bài báo không giải thích, nên tôi nêu cả ba thay vì chọn một.
Thực nghiệm & kết quả
| Nhóm game | Chiến đấu | Di chuyển | Đặc thù game |
|---|---|---|---|
| 3D | 61.2 | 55.0 | 56.3 |
| 2D nhìn từ trên xuống | 46.0 | 52.0 | 61.5 |
| 2D cuộn ngang | 44.8 | 37.9 | 54.0 |
| Thiết lập | Fine-tune từ NitroGen | Huấn luyện từ đầu | Mức tăng tương đối |
|---|---|---|---|
| Roguelike, 60 giờ | 53.0 | 48.1 | +10.2% |
| Roguelike, 120 giờ | 65.6 | 57.8 | +13.5% |
| Roguelike, 240 giờ | 81.0 | 76.0 | +6.6% |
| Action-RPG, chiến đấu | 73.3 | 48.3 | +51.8% |
| Action-RPG, di chuyển | 60.0 | 48.0 | +25.0% |
| Action-RPG, đặc thù game | 66.6 | 63.3 | +5.2% |
| Họ controller | R bình phương joystick | Độ chính xác nút theo khung |
|---|---|---|
| Xbox One | 0.92 | 0.98 |
| Xbox 360 | 0.91 | 0.93 |
| PS3 | 0.85 | 0.97 |
| PS4 | 0.84 | 0.91 |
| Xbox Series X | 0.79 | 0.98 |
| PS5 | 0.77 | 0.97 |
| Trung bình | 0.84 | 0.96 |
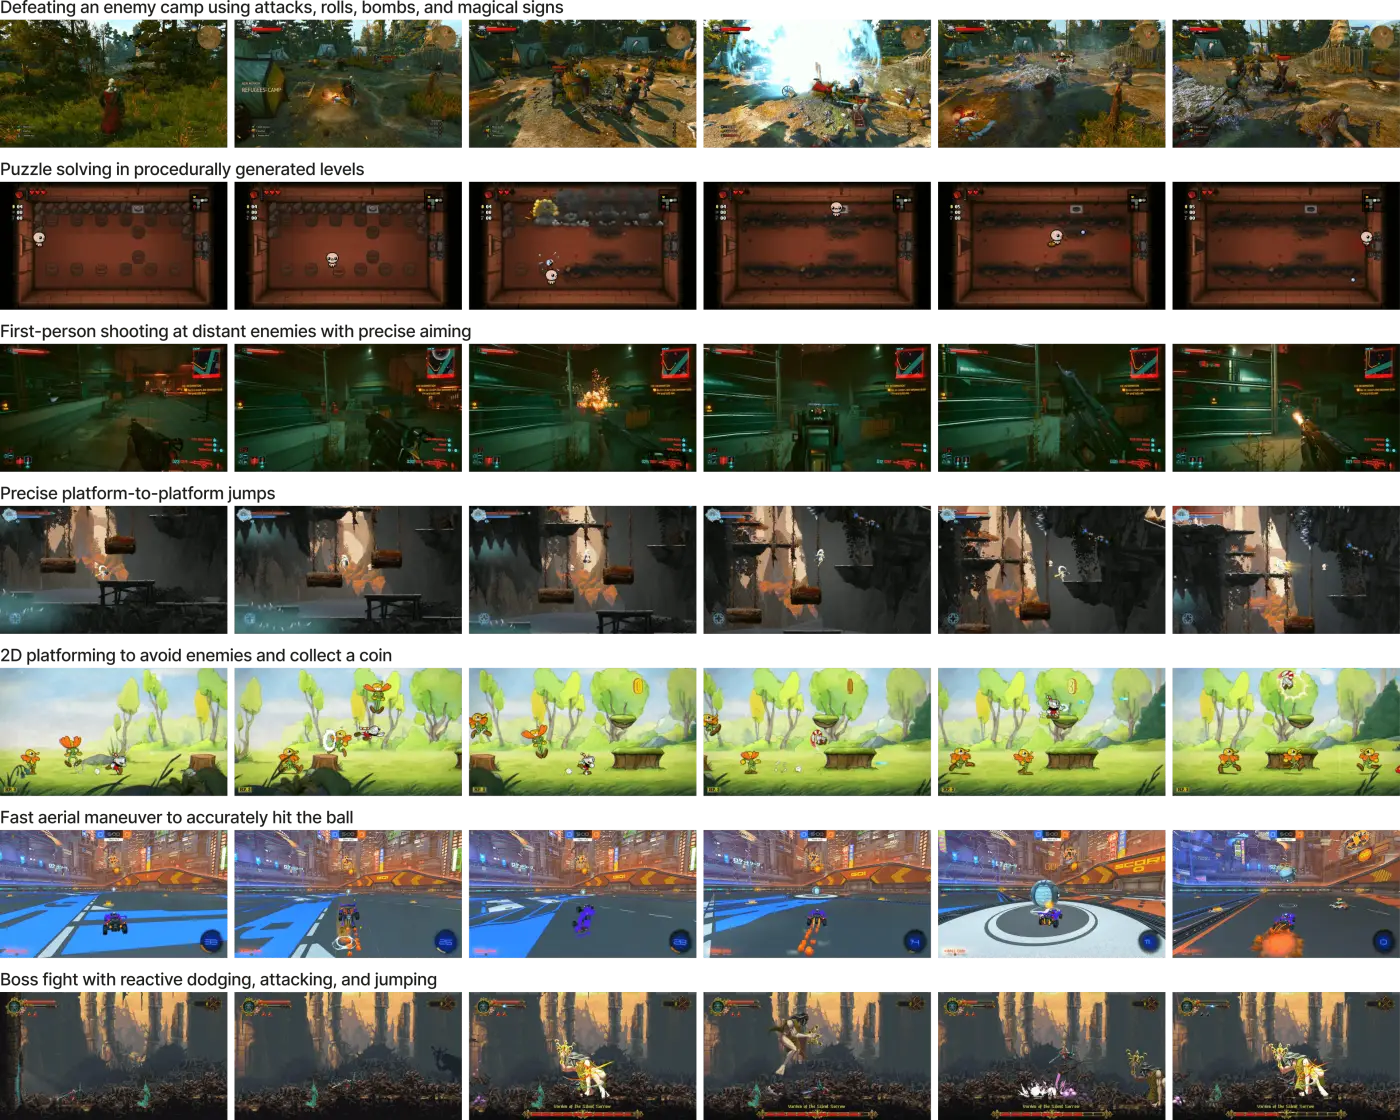
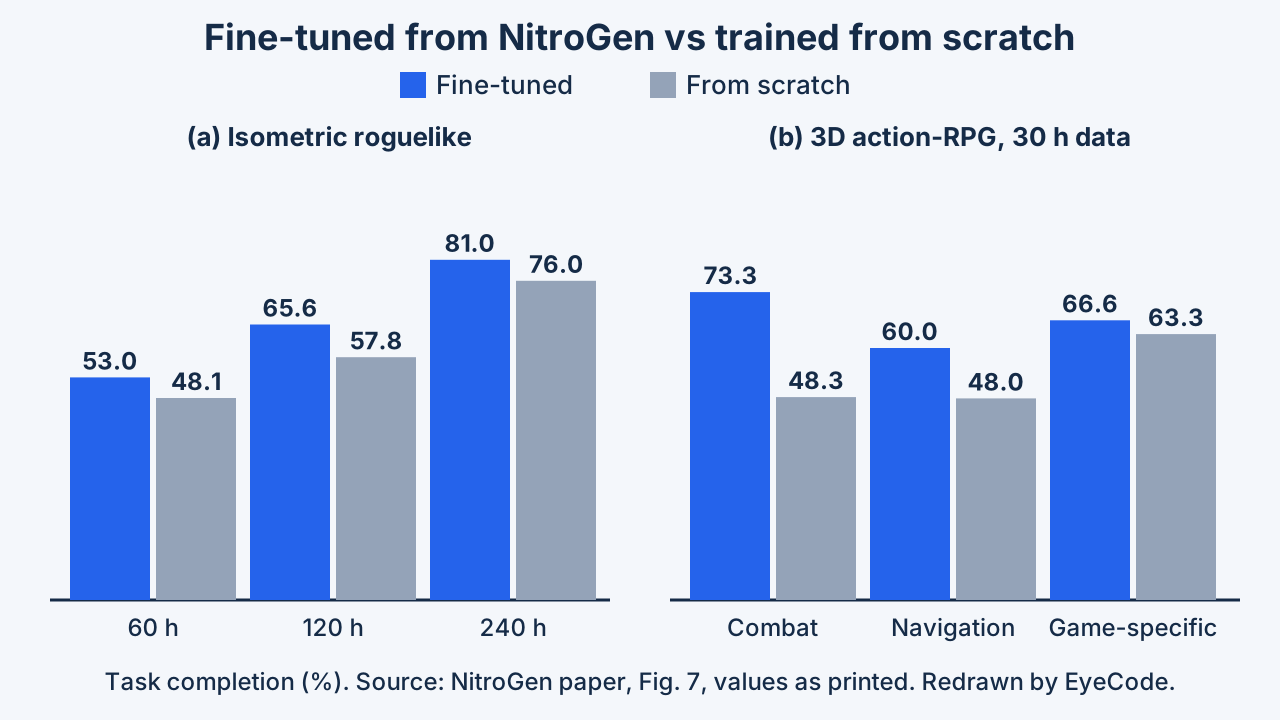
Sau khi xem nhiều game, mô hình đã làm được những việc đơn giản ở nhiều game mà không cần luyện thêm. Khi được luyện thêm một chút trên game mới, nó học nhanh hơn mô hình xuất phát từ số không, chủ yếu ở chiến đấu và di chuyển. Các bảng bên dưới có số liệu.
Giao thức. Parser được kiểm tra trên gameplay ghi từ sáu game với overlay ngẫu nhiên: R bình phương trung bình của joystick là 0,84 và độ chính xác nút theo khung trung bình là 0,96 (Bảng 3 bên dưới). Mô hình pretrain được đánh giá không fine-tune trên 3 tác vụ mỗi game, 5 lượt chạy mỗi tác vụ, người chấm thành công (Bảng 1). Với chuyển giao, một game bị giữ ngoài pretraining, sau đó fine-tune và so với cùng kiến trúc huấn luyện từ đầu với cùng dữ liệu và tính toán (Bảng 2). Baseline: chỉ có huấn luyện từ đầu; bài không so với agent nào khác.
Số liệu chính. Fine-tune cho cải thiện tương đối trung bình 10% theo các mức dữ liệu trên game roguelike isometric và khoảng 25% trên game action-RPG 3D. Với 30 giờ dữ liệu trên action-RPG: 52% cho chiến đấu, 25% cho di chuyển, 5% cho tác vụ đặc thù game.
Định tính và lưu ý. Hình 4 của bài cho thấy các lượt chạy trong game 2D và 3D, dài từ vài giây đến vài phút. Tác giả không thấy khác biệt đáng kể giữa tác vụ có thể ghi nhớ và tác vụ trong thế giới sinh thủ tục.
Cách đọc các bảng. Bảng 1 không có hệ thống so sánh: nó cho thấy một mô hình pretrain đạt gì theo nhóm game, trung bình trên 3 tác vụ và 5 lượt chạy mỗi game, nên mỗi ô dựa trên ít lượt chạy, và bài không báo cáo phương sai hay seed. Bảng 2 là so sánh có kiểm soát duy nhất; mức tăng tương đối ở đó do chúng tôi tính từ giá trị cột in trong hình, và khớp với 10%, 52%, 25% và 5% trong văn bản, một phép kiểm tra nhất quán hữu ích (mức trung bình 25% theo kích thước dữ liệu của action-RPG không có hình theo từng mức trong bài).
Diễn giải của tác giả. Mức tăng nhỏ hơn trên roguelike (khoảng 10%) so với action-RPG (khoảng 25%) được cho là do action-RPG có mặt nhiều hơn trong dữ liệu huấn luyện (Action-RPG chiếm 34,9% số giờ, Platformer 18,4%, Action-Adventure 9,2%, theo Hình 3). Mức tăng lớn nhất ở kỹ năng chung (chiến đấu, di chuyển) và rất nhỏ ở cơ chế đặc thù game, gợi ý mô hình học được kỹ năng chơi chung có thể chuyển giao còn phần đặc thù vẫn cần huấn luyện riêng. Trong Bảng 2, mức tăng trên roguelike giảm từ 13,5% ở 120 giờ xuống 6,6% ở 240 giờ theo phép tính của chúng tôi, nhưng chỉ có ba điểm và không có phương sai nên đây là quan sát, không phải kết luận.
Ghi chú về dữ liệu và parser. Thống kê dataset (Hình 3): 846 game có hơn một giờ dữ liệu, 91 game hơn 100 giờ và 15 game hơn 1.000 giờ. Trung bình của parser che đi độ phân tán theo họ controller (R bình phương từ 0,77 đến 0,92; độ chính xác nút từ 0,91 đến 0,98). Bài liệt kê các nguồn nhiễu: trễ overlay và sai số parse, vật thể do người sáng tạo thêm như chat livestream hay lời nhắc subscribe, và ánh xạ nút hay độ nhạy khác nhau.
Không có trong bài: ablation giữa pretrain đa game và đơn game, so sánh với agent khác, kết quả trên nhiều hơn hai game bị giữ lại, và tên các game bị giữ lại. Con số 52% đến từ một game, một mức dữ liệu và nhóm tác vụ chiến đấu.
Hạn chế
Mô hình chỉ phản ứng với những gì nó thấy ngay lúc này. Nó không thể lập kế hoạch dài hay làm theo chỉ dẫn bằng lời, và phần lớn dữ liệu luyện là game hành động chơi bằng tay cầm. Nghiên cứu cũng chỉ thử trên hai game bị giữ lại.
Do tác giả nêu
Mục 4 nói NitroGen là mô hình cảm giác "system-1" phản ứng nhanh: không thể lập kế hoạch dài hạn hay làm theo chỉ dẫn ngôn ngữ, chỉ phản ứng với ngữ cảnh ngắn nó thấy. Dataset lệch về game hành động chơi bằng tay cầm; game chỉ dùng bàn phím ít được đại diện, có thể hạn chế khả năng tổng quát hóa sang game chiến lược hoặc mô phỏng. Mục 3 thêm nhiễu nhãn do trễ overlay, sai số parse và ánh xạ controller khác nhau. Kho mã nói agent chỉ chạy với game Windows.
Phân tích của EyeCode (diễn giải biên tập)
Baseline duy nhất là chính mô hình huấn luyện từ đầu, và chuyển giao chỉ được chứng minh trên hai game bị giữ lại với thành công do con người chấm, nên kết quả cho thấy một xu hướng chứ chưa phải bảng xếp hạng rộng. Trọng số và nhãn có giấy phép phi thương mại.
Do tác giả nêu
- Mô hình phản xạ system-1: không lập kế hoạch dài hạn, không làm theo ngôn ngữ; hướng tương lai là hậu huấn luyện bằng ngôn ngữ và học tăng cường.
- Dataset lệch về game hành động và chơi bằng tay cầm; thể loại chỉ dùng bàn phím và nặng thao tác ít được đại diện.
- Nhiễu nhãn do trễ overlay, sai số parse, vật thể do người sáng tạo thêm và ánh xạ lại controller.
- Giới hạn simulator: chạy với game dùng đồng hồ hệ thống; triển khai thời gian thực hoặc bất đồng bộ để lại cho tương lai. Ảnh hưởng của việc tạm dừng lên vật lý đã được kiểm tra; các bản phát lại lệch sau khoảng một phút (hành động liên tục) hoặc ba phút (hành động rời rạc), có và không tạm dừng, và tác giả quy cho sai số tích lũy.
- Model card nói mô hình hoạt động tốt nhất với game thiết kế cho tay cầm và kém hiệu quả với game chủ yếu dùng chuột và bàn phím (ví dụ RTS và MOBA).
Phân tích của EyeCode (diễn giải biên tập)
- Độ rộng bằng chứng: một baseline (từ đầu), hai game bị giữ lại, số lượt chạy cho fine-tune không được nêu trong văn bản, không có phương sai; thành công do người chấm nên khó tái lập chính xác.
- Các tuyên bố thiết kế chưa kiểm chứng bằng số: chunk hành động cải thiện nhất quán thời gian và thêm khung không giúp ích đều được nêu không kèm con số.
- Mâu thuẫn chưa giải quyết: số chiều hành động mỗi bước xuất hiện là 20, 24 và 21 ở các nơi khác nhau (xem phần Phương pháp).
- Khả năng tái lập: dataset card nói tái lập bài báo cần lọc thêm như lọc khung nhàn rỗi, và dataset chứa nhãn hành động cho video chứ không chứa video; mô hình theo giấy phép phi thương mại của NVIDIA và dataset theo CC BY-NC 4.0.
Điểm cần nhớ
Video có hiện tay cầm có thể biến thành bộ dữ liệu huấn luyện khổng lồ. Pretrain trên nhiều game giúp có lợi thế khi gặp game mới, nhất là với kỹ năng chung như chiến đấu và di chuyển.
Các bài học mà bằng chứng ủng hộ:
- Overlay làm nhãn hành động rẻ ở quy mô lớn: 71.000 giờ thô thành 40.000 giờ đã lọc trên hơn 1.000 game.
- Parser huấn luyện trên overlay tổng hợp đọc được overlay thật: R bình phương joystick 0,84 và độ chính xác nút 0,96.
- Một không gian hành động chung cho phép một policy duy nhất bao trùm nhiều game.
- Với cùng ngân sách, pretraining giúp ích trên cả hai game bị giữ lại, nhiều nhất ở chiến đấu và di chuyển, ít nhất ở tác vụ đặc thù game.
- Mô hình là phản xạ, không phải bộ lập kế hoạch.
Hướng gợi ý (đề xuất của EyeCode, không phải kết luận của bài báo)
- Kiểm tra pretrain đa game có hơn pretrain đơn game ở cùng số giờ không.
- Đo mức nhiễu nhãn ảnh hưởng bao nhiêu bằng cách huấn luyện trên nhãn đã lọc so với nhãn thô.
Bài học kỹ thuật:
- Giám sát yếu từ kết quả đọc trực quan có thể thay thu thập thủ công, nhưng cần lọc đoạn nhàn rỗi: tác giả ghi nhận dữ liệu thô khiến mô hình dự đoán quá nhiều hành động rỗng.
- Che overlay ngăn policy chép nhãn từ đầu vào.
- Segmentation trên lưới joystick rời rạc tốt hơn hồi quy tọa độ trực tiếp, theo tác giả.
- Flow matching với chunk 16 hành động, trọng số EMA và một khung hình đủ cho benchmark; 16 bước khử nhiễu ngang với số bước lớn hơn.
- Chuyển giao không đồng đều và gắn với mức độ game mới được đại diện trong dữ liệu pretrain.
Hướng gợi ý (đề xuất của EyeCode, không phải kết luận của bài báo)
- Ablation chất lượng nhãn: so sánh huấn luyện trên nhãn thô, nhãn đã lọc và nhãn sửa tay.
- Báo cáo phương sai theo seed, thêm game bị giữ lại và baseline bên ngoài.
- Thêm tầng ngôn ngữ hoặc bộ lập kế hoạch lên policy phản xạ và thử tác vụ dài hạn.