
MegaSaM: Accurate, Fast and Robust Structure and Motion from Casual Dynamic Videos
MegaSaM ước lượng camera và độ sâu từ video đơn mắt có chuyển động cảnh và camera không kiểm soát. Các thay đổi trong huấn luyện và suy luận của deep visual SLAM nhắm đến video đời thường mà giả định cảnh tĩnh không còn phù hợp.
Video quay bằng điện thoại thường có người, xe chuyển động và camera ít tịnh tiến, khiến SfM và SLAM cổ điển dễ hỏng. MegaSaM sửa phần huấn luyện và suy luận của một hệ SLAM học sâu để xử lý các trường hợp đó. Bài phân tích này đi qua bài toán, phương pháp, số liệu và hạn chế.
Tổng quan
Hãy tưởng tượng bạn quay một con phố bằng điện thoại trong khi người đi bộ và xe chạy qua. MegaSaM là chương trình xem đoạn video đó và tính ra điện thoại đã ở đâu tại mỗi thời điểm, cùng khoảng cách tới mọi vật, kể cả khi nhiều thứ trong cảnh đang chuyển động. CVPR 2025 đã ghi nhận bài báo này là Best Paper Honorable Mention.
MegaSaM nhận một video thông thường từ một camera, có thể đầy người, xe hay động vật đang di chuyển, và ước lượng ba thứ: tư thế camera ở từng khung hình, tiêu cự nếu chưa biết, và bản đồ độ sâu dày cho mỗi khung. Hệ thống điều chỉnh DROID-SLAM, một hệ SLAM thị giác dựa trên học sâu, để vẫn hoạt động khi cảnh không tĩnh và khi camera gần như không tịnh tiến. Giai đoạn thứ hai tinh chỉnh độ sâu để các khung hình nhất quán với nhau. CVPR 2025 liệt kê bài báo ở hạng Best Paper Honorable Mention, đây là ghi nhận chính thức của hội nghị. Mức độ phù hợp với bài toán của bạn nên được đánh giá qua thực nghiệm, không phải qua giải thưởng. Các tác giả đến từ Google DeepMind, UC Berkeley và Đại học Michigan.
MegaSaM là pipeline gồm hai phần: một hệ SLAM thị giác sâu đã sửa đổi (dòng DROID-SLAM) trả về tư thế camera trong SE(3), tiêu cự tùy chọn và disparity độ phân giải thấp; sau đó là bước tối ưu độ sâu video nhất quán (theo tinh thần CasualSAM) cho depth độ phân giải đầy đủ kèm bản đồ độ bất định cho từng khung.
Đóng góp không phải backbone mới mà là một loạt thay đổi ở huấn luyện và suy luận: bản đồ chuyển động của vật thể được học, quy trình huấn luyện hai giai đoạn, khởi tạo bằng monocular depth đã căn theo metric depth, và bundle adjustment toàn cục có nhận biết độ bất định. Bài báo báo cáo kết quả trên MPI Sintel, DyCheck và 12 video ngoài thực tế; hội nghị liệt kê bài ở hạng Best Paper Honorable Mention.
Bài toán nghiên cứu
Các phương pháp cũ dựng đường đi camera giả định thế giới đứng yên và camera di chuyển ngang đủ nhiều để nhìn vật từ các góc khác nhau. Video điện thoại thật phá cả hai quy tắc: đồ vật chuyển động, và người quay thường chỉ xoay tại chỗ. Các phương pháp nơ-ron mới hơn thì hoặc rất chậm hoặc dễ hỏng với những video như vậy.
Structure-from-motion và SLAM cổ điển giả định cảnh phần lớn tĩnh và có đủ parallax, nghĩa là camera phải tịnh tiến để điểm gần và điểm xa dịch chuyển khác nhau. Video đời thường vi phạm điều này: vật thể di chuyển, camera có thể chỉ xoay, và trường nhìn thường không biết. Các giải pháp học sâu trước đó hoặc fine-tune mạng trên từng video nên chậm, hoặc dễ hỏng khi tiêu cự không rõ, chuyển động thiên về xoay, hay nội dung động chiếm ưu thế. Bài toán: cho N khung hình từ video đơn mắt, xuất tư thế camera, tiêu cự khi chưa biết và độ sâu từng khung, mà không giới hạn chuyển động của camera hay vật thể. Đánh giá bằng sai số tư thế camera và sai số độ sâu so với ground truth khi có.
Về hình thức, từ N khung hình hệ thống ước lượng G_i thuộc SE(3), tiêu cự f và độ sâu D_i, không giả định gì về chuyển động camera hay vật thể. Các dạng lỗi mà tác giả nhắm tới: (1) pixel động làm hỏng tương ứng trong bundle adjustment, (2) video gần như xoay thuần hoặc ít parallax khiến độ sâu bị ràng buộc yếu bởi hình học đa góc nhìn, và (3) nội tham số chưa biết.
Các baseline cho thấy bức tranh chung: CasualSAM và RoDynRF tối ưu đồng thời camera và hình học qua mạng mono-depth hoặc instant-NGP; Particle-SfM và LEAP-VO che vật thể động bằng phân đoạn chuyển động từ quỹ đạo dài; ACE-Zero nhắm tới cảnh tĩnh qua hồi quy tọa độ cảnh; MonST3R mở rộng DUSt3R cho cảnh động bằng point cloud theo cặp.
Ý tưởng chính
Giữ một bộ máy theo dõi camera tốt, nhưng dạy nó thêm hai kỹ năng: bỏ qua những thứ đang chuyển động, và chỉ dựa vào ước đoán độ sâu từ một ảnh khi riêng chuyển động camera chưa đủ thông tin. Sau đó làm mịn bản đồ độ sâu để không bị nhấp nháy.
Ý tưởng chính là giữ nguyên bộ máy hình học mạnh của DROID-SLAM, với bundle adjustment khả vi, và thay đổi thứ đưa vào đó. Thứ nhất, một mạng dự đoán bản đồ xác suất chuyển động để pixel trên vật thể động bị giảm trọng số trong tối ưu. Thứ hai, mạng này được huấn luyện ở giai đoạn riêng sau khi bộ theo dõi camera đã học xong trên dữ liệu tĩnh; tác giả cho rằng cách này ổn định hơn học mọi thứ cùng lúc. Thứ ba, độ sâu dự đoán từ một ảnh được dùng để khởi tạo và làm regularizer mềm, nhưng cường độ chỉ tăng khi chính hệ thống báo độ bất định cao, ví dụ khi parallax yếu.
Ba ý tưởng chính. (a) Trọng số nhận biết chuyển động: mạng F_m xuất bản đồ xác suất ở độ phân giải 1/8, nhân vào trọng số tin cậy của mạng flow trong bundle adjustment. (b) Huấn luyện hai giai đoạn: tiền huấn luyện ego-motion trên dữ liệu tĩnh tổng hợp, rồi đóng băng bộ theo dõi và chỉ huấn luyện F_m trên dữ liệu động với cross-entropy cùng loss camera.
(c) Bundle adjustment toàn cục có nhận biết độ bất định: Hessian của bài toán tối ưu được dùng, qua xấp xỉ kiểu Laplace, như thước đo mức độ xác định của độ sâu và tiêu cự. Khi Hessian cho thấy chúng bị ràng buộc yếu, trọng số của monocular depth tăng lên và việc tinh chỉnh tiêu cự có thể bị tắt.
Phương pháp
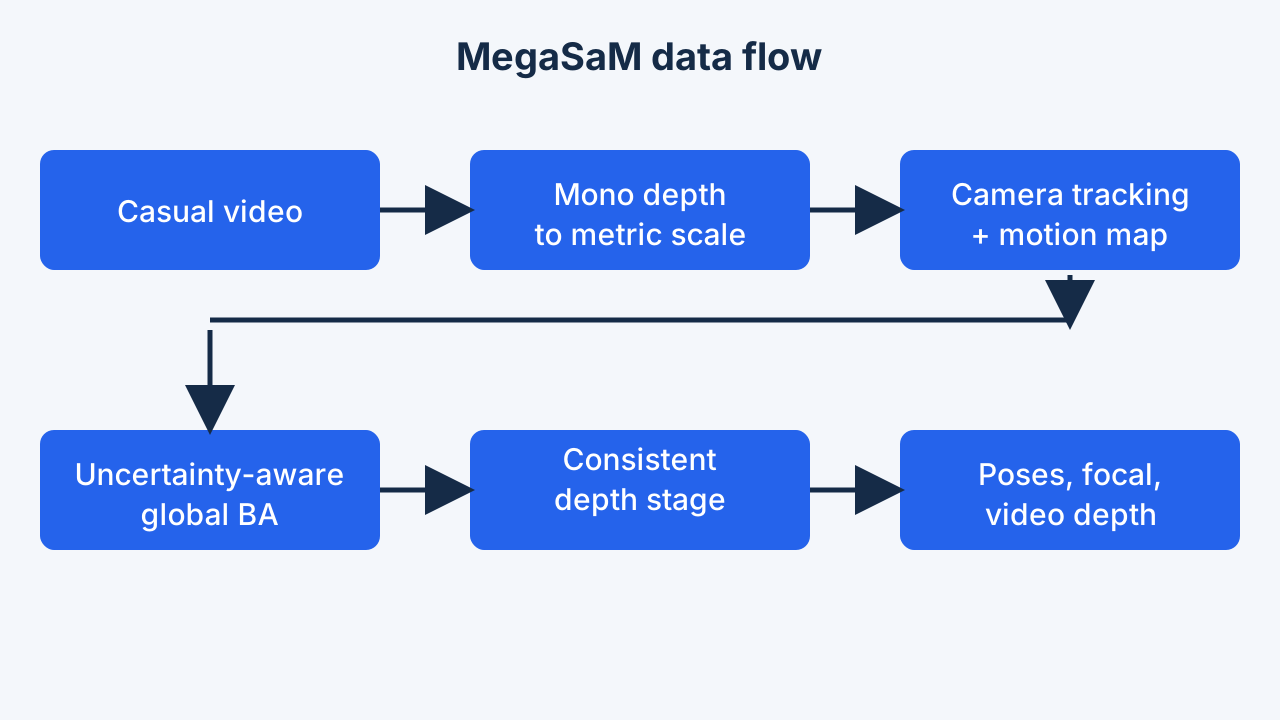
Pipeline gồm vài bước. Đầu tiên ước đoán độ sâu từng khung từ một ảnh và đổi về đơn vị thực. Rồi theo dõi camera trong khi giảm trọng số những vật đang chuyển động. Cuối cùng làm sạch độ sâu để các khung kề nhau khớp nhau.
Pipeline gồm bốn bước. (1) Độ sâu từ một ảnh của Depth Anything được căn theo metric depth của UniDepth bằng cách khớp median; UniDepth cũng cho tiêu cự ban đầu. (2) Bộ theo dõi, một ConvGRU dự đoán flow và độ tin cậy trên đồ thị khung hình, được khởi tạo với 8 keyframe bằng bundle adjustment chỉ camera, rồi chạy tối ưu cửa sổ trượt có regularizer độ sâu. (3) Phần backend chạy bundle adjustment toàn cục trên keyframe, tối ưu pose graph cho các khung còn lại, và một lần điều chỉnh toàn cục cuối cùng trên mọi khung. (4) Giai đoạn độ sâu nhất quán cố định camera và tối ưu độ sâu cùng độ bất định bằng loss chiếu lại flow của RAFT, loss nhất quán theo thời gian và loss tiên nghiệm độ sâu. Huấn luyện dùng 163 cảnh TartanAir và 5K video Kubric tĩnh ở giai đoạn một, rồi 11K video Kubric động ở giai đoạn hai.
Bộ theo dõi và huấn luyện. Bộ mã hóa đặc trưng và ngữ cảnh theo DROID-SLAM ở độ phân giải 1/8; toán tử cập nhật dự đoán flow, độ tin cậy và hệ số damping cho Levenberg-Marquardt. Phần bù Schur khai thác khối disparity chéo, tiêu cự là một biến thêm. Mạng chuyển động F_m gộp đặc trưng theo không gian rồi theo thời gian qua các keyframe lân cận. Giai đoạn một tối thiểu hóa loss camera cộng loss flow (trọng số 0,02); giai đoạn hai thêm cross-entropy chuyển động (trọng số 0,1). Loss tư thế là chuẩn của log SE(3) giữa tư thế thật và dự đoán, áp dụng sau mỗi vòng lặp BA thứ k với trọng số 0,9^k (in là gamma = 0,9^k); loss flow là sai khác l2 trung bình giữa flow dự đoán và flow thật trên các khung kề nhau. Mẫu huấn luyện dài 7 khung, lấy sao cho flow trung bình giữa chúng từ 0,5 đến 64 px; disparity chuẩn hóa sao cho phân vị 98 bằng 2; tiêu cự ban đầu nhiễu 25 phần trăm; Adam, khoảng 4 ngày trên 8 GPU A100 80GB.
Suy luận. Trọng số regularizer mono-depth là 0,05 ở khởi tạo và frontend; ở backend bằng gamma 1e-4 nhân exp(-0,05 nhân median đường chéo Hessian của disparity), và việc tinh chỉnh tiêu cự bị tắt khi phần tử Hessian tương ứng dưới ngưỡng 50.
Giai đoạn độ sâu. Tổng chi phí kết hợp các số hạng flow, thời gian và tiên nghiệm với trọng số 1,0, 0,2 và 1,0. Tiên nghiệm gồm loss bất biến tỉ lệ, khớp gradient đa tỉ lệ và loss pháp tuyến (trọng số 4). Cặp khung dùng độ lệch 1, 2, 4, 8 và 15. Khác CasualSAM, camera được cố định và không fine-tune mạng; 100 bước khởi động rồi 400 bước tối ưu chung.
Thực nghiệm & kết quả
| Phương pháp | ATE calibrated | RTE calibrated | RRE calibrated | ATE uncalibrated | RTE uncalibrated | RRE uncalibrated | Thời gian |
|---|---|---|---|---|---|---|---|
| CasualSAM | 0.036 | 0.013 | 0.20 | 0.067 | 0.019 | 0.47 | 1.6m |
| LEAP-VO | 0.041 | 0.023 | 0.17 | - | - | - | 1.3s |
| ACE-Zero | 0.053 | 0.028 | 0.30 | 0.065 | 0.028 | 1.92 | 10s |
| Particle-SfM | 0.062 | 0.032 | 1.26 | 0.057 | 0.038 | 1.64 | 21s |
| RoDynRF | 0.110 | 0.049 | 1.68 | 0.109 | 0.051 | 1.32 | 15m |
| MonST3R | - | - | - | 0.078 | 0.038 | 0.49 | 1.0s |
| MegaSaM (ours) | 0.018 | 0.008 | 0.04 | 0.023 | 0.008 | 0.06 | 1.0s |
| Phương pháp | Sintel abs-rel | Sintel log-rmse | Sintel δ1.25 | DyCheck abs-rel | DyCheck log-rmse | DyCheck δ1.25 |
|---|---|---|---|---|---|---|
| DA-v2 | 0.37 | 0.55 | 58.6 | 0.20 | 0.27 | 84.7 |
| DepthCrafter | 0.27 | 0.50 | 68.2 | 0.22 | 0.29 | 83.7 |
| CasualSAM | 0.31 | 0.49 | 64.2 | 0.21 | 0.30 | 78.4 |
| MonST3R | 0.31 | 0.43 | 62.5 | 0.26 | 0.35 | 66.5 |
| MegaSaM (ours) | 0.21 | 0.39 | 73.1 | 0.11 | 0.20 | 94.1 |
| Cấu hình | ATE | RTE | RRE | Độ sâu abs-rel | Độ sâu δ1.25 |
|---|---|---|---|---|---|
| Droid-SLAM | 0.030 | 0.022 | 0.50 | - | - |
| w/o mono-init. | 0.038 | 0.026 | 0.49 | - | - |
| w/o m^i (no movement map) | 0.032 | 0.127 | 0.14 | - | - |
| w/o 2-stage train. | 0.035 | 0.136 | 0.17 | - | - |
| w/o u-BA | 0.033 | 0.013 | 0.11 | - | - |
| w/ ft-pose | 0.041 | 0.018 | 0.33 | 0.23 | 71.2 |
| w/o new C_prior | - | - | - | 0.36 | 72.5 |
| Full | 0.019 | 0.008 | 0.04 | 0.21 | 73.1 |
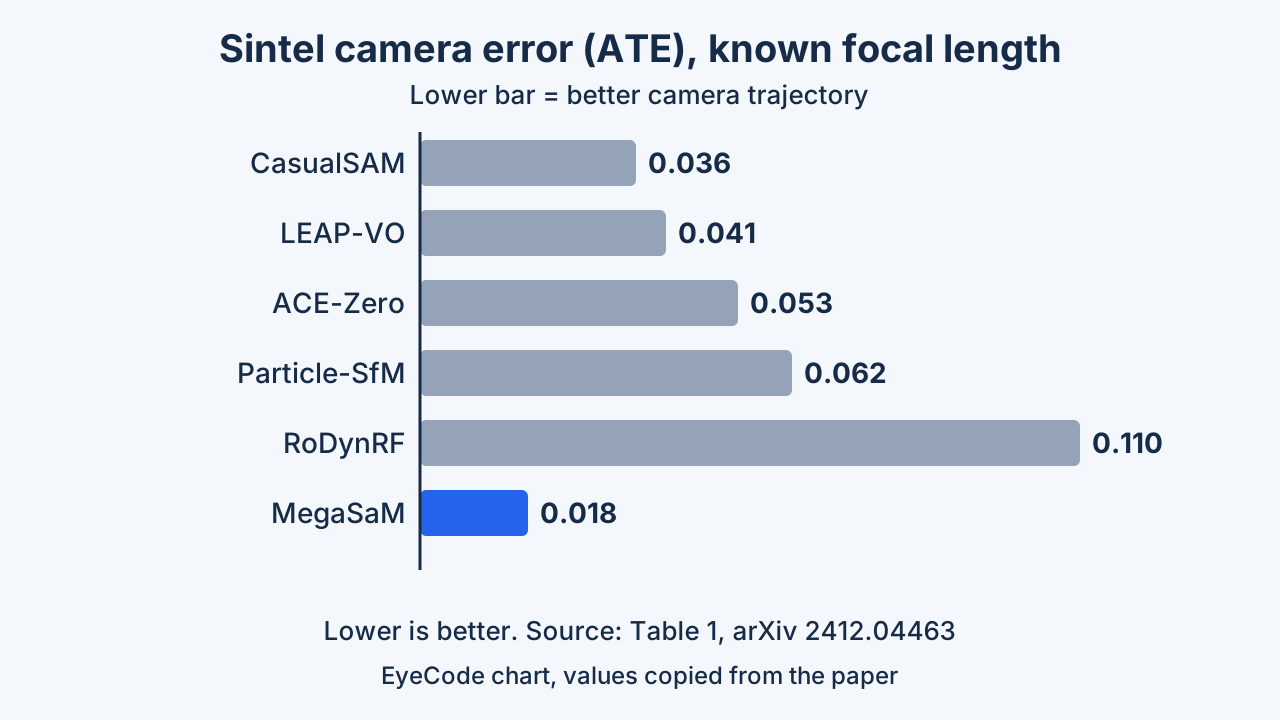
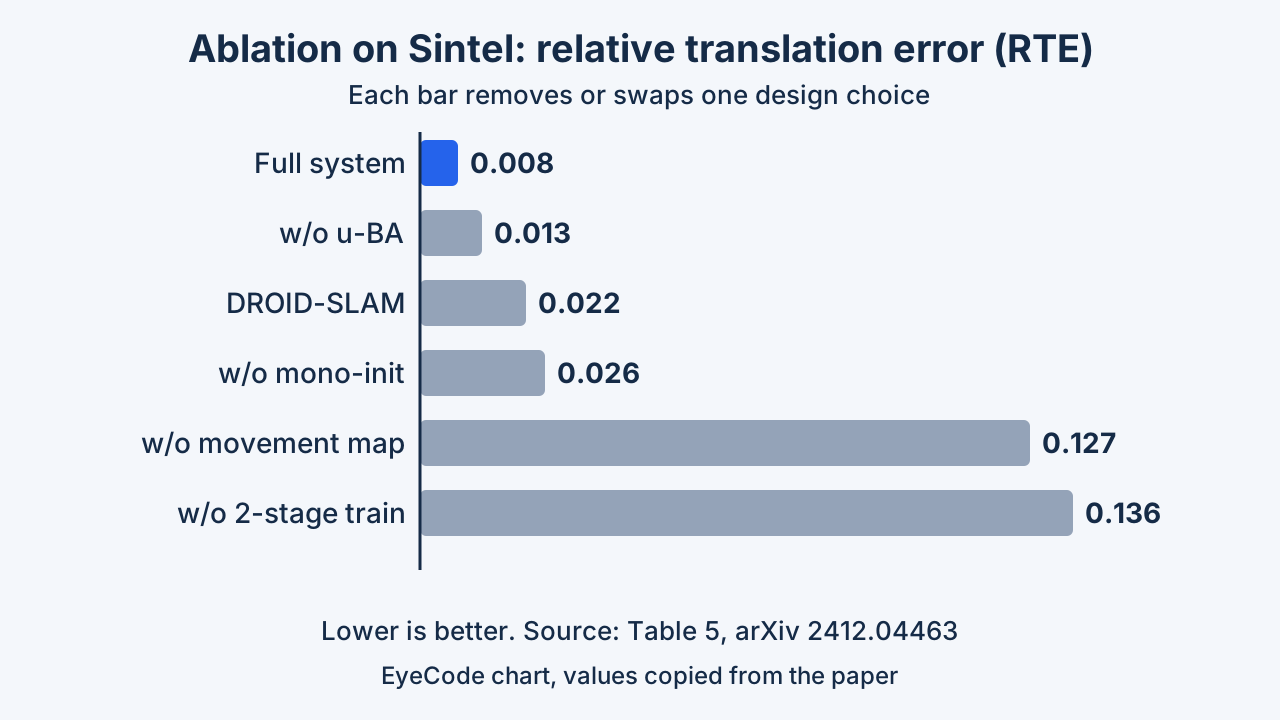
Trên ba bộ kiểm thử, đường đi camera và bản đồ độ sâu của MegaSaM gần sự thật hơn các phương pháp được so sánh, với tốc độ tương đương hoặc nhanh hơn. Khi tác giả tắt từng thành phần thêm vào, kết quả đều tệ đi.
Tư thế camera được chấm bằng ATE, RTE và RRE sau khi căn quỹ đạo với ground truth; độ sâu bằng abs-rel, log-RMSE và tỉ lệ điểm trong ngưỡng 1,25 (delta 1,25). Benchmark gồm MPI Sintel, DyCheck và 12 video ngoài đời của DynIBaR, với tiêu cự biết trước (calibrated) và chưa biết (uncalibrated). Baseline: CasualSAM, LEAP-VO, ACE-Zero, Particle-SfM, RoDynRF, MonST3R; về độ sâu thêm DepthCrafter, Depth Anything V2. Bảng dưới chép Bảng 1, 4, 5. Trên Sintel (Bảng 1), MegaSaM đạt ATE 0,018 khi biết tiêu cự so với 0,036 của CasualSAM, và 0,023 khi chưa biết so với 0,078 của MonST3R. Trên DyCheck (Bảng 2) ATE là 0,020, so với 0,062 và 0,056 của baseline tốt nhất là ACE-Zero; trên tập ngoài đời (Bảng 3) là 0,004, so với 0,016 của LEAP-VO. Về độ sâu (Bảng 4), abs-rel trên Sintel là 0,21 so với 0,27 của DepthCrafter, trên DyCheck là 0,11 so với 0,20 của Depth Anything V2. Ablation (Bảng 5): RTE trên Sintel tăng từ 0,008 lên 0,127 khi bỏ bản đồ chuyển động và 0,136 khi bỏ huấn luyện hai giai đoạn. Định tính: trên clip DAVIS xoay là chính, CasualSAM cho đám mây điểm méo, MonST3R coi xoay là tịnh tiến (Hình 7).
Quy trình đánh giá. Quỹ đạo thật được chuẩn hóa về độ dài đơn vị, ước lượng được căn bằng phép Sim(3) toàn cục kiểu Umeyama; độ sâu căn bằng một scale và shift toàn cục và loại điểm xa hơn 100 m. Sintel dùng 18 chuỗi, mỗi chuỗi 20 đến 50 ảnh. Video DyCheck dài 180 đến 500 khung, ground truth là camera đã tinh chỉnh và độ sâu cảm biến do Shape of Motion cung cấp. Tập ngoài đời gồm 12 video DynIBaR dài 100 đến 600 khung, camera chuẩn lấy từ COLMAP sau khi che vật thể chuyển động bằng mask phân đoạn thực thể với ID chọn thủ công. Thời gian chạy là tổng thời gian chia số khung, mọi baseline chạy trên một A100. Tinh chỉnh độ sâu chạy khoảng 1,3 FPS ở 336x144 trên Sintel, đánh giá ở 672x288.
Kết quả tư thế. Bảng 2 (DyCheck): ATE 0,020 ở cả hai thiết lập, so với ACE-Zero 0,062 / 0,056, Particle-SfM 0,081 / 0,087 và CasualSAM 0,185 / 0,209. Bảng 3 (ngoài đời): ATE 0,004, so với LEAP-VO 0,016 và CasualSAM 0,031 khi calibrated, và MonST3R 0,073 khi uncalibrated. Bảng 4: delta 1,25 đạt 73,1 trên Sintel (DepthCrafter 68,2) và 94,1 trên DyCheck (DA-v2 84,7). Bài đối chiếu với MonST3R, vốn dùng biểu diễn đám mây điểm toàn cục mới hơn, và vẫn báo cáo độ chính xác và độ bền tốt hơn.
Ablation (Bảng 5, Sintel). Khi bỏ khởi tạo mono-depth, ATE tăng lên 0,038 (Droid-SLAM: 0,030); khi bỏ bản đồ chuyển động ATE là 0,032 nhưng RTE vọt lên 0,127, và khi bỏ huấn luyện hai giai đoạn là 0,035 và 0,136, đều cao hơn nhiều so với Droid-SLAM thuần (RTE 0,022). Diễn giải của chúng tôi: nhồi dữ liệu động một cách ngây thơ làm hỏng phần tịnh tiến còn nhiều hơn là không huấn luyện với nó, phù hợp với nhận xét của tác giả rằng huấn luyện chung không ổn định. Luôn bật regularizer mono-depth (w/o u-BA) cho 0,033, 0,013, 0,11 so với 0,019, 0,008, 0,04 của hệ đầy đủ. Về độ sâu, tinh chỉnh tư thế đồng thời (ft-pose) làm abs-rel xấu đi thành 0,23 và dùng loss prior kiểu CasualSAM thành 0,36 (đầy đủ: 0,21).
Lưu ý. Ablation chỉ chạy trên Sintel, gồm các chuỗi ngắn, và các bảng không có sai số lặp lại. Dòng Full của Bảng 5 in ATE 0,019 trong khi Bảng 1 in 0,018 cho MegaSaM trên Sintel; bài không nói Bảng 5 dùng thiết lập nào, cũng không giải thích chênh lệch (chúng tôi ngờ do làm tròn hoặc chạy khác, đây chỉ là phỏng đoán). Bảng độ sâu ghi DepthCrafter còn đoạn văn mô tả baseline ghi VideoCrafter [20], có vẻ là lỗi đánh máy.
Hạn chế
Hệ thống vẫn bối rối khi vật chuyển động chiếm gần hết khung hình, hoặc trong video tự quay selfie khi người và camera cùng di chuyển. Nó cũng giả định độ zoom không đổi trong suốt đoạn video.
Do tác giả nêu
Bài có đoạn Hạn chế ngắn và Phụ lục B. Theo dõi camera hỏng khi vật động chiếm cả khung hình hoặc không có gì đáng tin để bám (Hình 8, hàng trên); cũng khó khi chuyển động camera và vật cùng phương, ví dụ video selfie (Hình 8, hàng dưới). Hệ thống không xử lý tiêu cự thay đổi hay méo xuyên tâm mạnh. Tác giả nêu prior tốt hơn từ mô hình nền tảng là hướng tương lai. Thất bại chỉ có hình, không có số.
Phân tích của EyeCode (diễn giải biên tập)
Ground truth của benchmark ngoài đời đến từ COLMAP sau khi che vật động, nên đo mức khớp với một pipeline khác chứ không phải cảm biến. Hệ thống dựa vào Depth Anything, UniDepth và RAFT huấn luyện sẵn, và bài không khảo sát lỗi của chúng lan truyền ra sao. Huấn luyện chỉ trên dữ liệu tổng hợp và ablation chỉ trên một benchmark nhỏ.
Do tác giả nêu
Hỏng khi vật động chiếm ưu thế hoặc không có gì ổn định để bám (Hình 8, hàng trên); khó khi chuyển động vật và camera cùng phương (Hình 8, hàng dưới, video selfie); không hỗ trợ tiêu cự thay đổi hay méo xuyên tâm mạnh trong một video. Nội tham số được mô hình hóa bằng một tiêu cự chung cho cả video, nên zoom nằm ngoài mô hình. Tác giả đề xuất prior tốt hơn từ mô hình nền tảng như hướng tương lai.
Phân tích của EyeCode (diễn giải biên tập)
Nội dung động làm hỏng bundle adjustment có trọng số khi còn quá ít pixel tĩnh, và bản đồ chuyển động huấn luyện trên chuyển động Kubric tổng hợp có thể chưa bao quát mọi kiểu chuyển động thật; bài không có thí nghiệm về điều này. Chuyển động cùng phương mơ hồ với mọi phương pháp phân đoạn chuyển động dựa vào chuyển động biểu kiến. Phụ thuộc vào ba mô hình huấn luyện sẵn, dữ liệu huấn luyện chủ yếu tổng hợp và ground truth giả trên một benchmark là các lưu ý thêm; thời gian chạy do chính tác giả đo trên một A100 bằng mã công khai của từng baseline nên không độc lập.
Điểm cần nhớ
Hình học truyền thống cộng với vài trợ thủ học sâu có thể xử lý video điện thoại lộn xộn. Các trợ thủ quyết định cái gì nên bỏ qua và khi nào nên tin vào ước đoán độ sâu từ một ảnh.
Bốn điểm. Một, MegaSaM giữ lõi SLAM khả vi và sửa điểm yếu trên video động bằng bản đồ chuyển động và huấn luyện theo giai đoạn. Hai, độ sâu một ảnh giúp khởi tạo và regularize, dùng thích ứng theo độ bất định. Ba, trên ba benchmark nó vượt các baseline liệt kê về tư thế và độ sâu, khoảng một giây mỗi khung. Bốn, còn giới hạn: chuyển động chiếm ưu thế, chuyển động cùng phương, tiêu cự thay đổi.
Hướng gợi ý (đề xuất của EyeCode, không phải kết luận của bài báo)
- Thử các clip có zoom hoặc méo mạnh để xem giả định tiêu cự cố định bắt đầu hỏng từ đâu.
- Hoán đổi các mô hình mono-depth và đo độ nhạy của sai số tư thế với chúng.
Bài học thiết kế từ bài báo: tách cái được học (chuyển động bản thân trước, rồi mặt nạ chuyển động) để huấn luyện ổn định; dùng độ cong của chính bộ tối ưu làm tín hiệu bất định rẻ để điều khiển prior; cố định camera khi tinh chỉnh độ sâu thay vì đánh đổi giữa tư thế và độ khớp độ sâu, như ablation ft-pose gợi ý; và kết hợp một mô hình mono-depth cho độ nhất quán với một mô hình khác cho tỉ lệ.
- Huấn luyện ngây thơ trên dữ liệu động làm hỏng tịnh tiến: Bảng 5 cho RTE 0,127 đến 0,136 khi bỏ bản đồ chuyển động hoặc huấn luyện hai giai đoạn.
- Chỉ nên bật regularizer mono-depth khi hình học khó quan sát; luôn bật cho RTE 0,013 so với 0,008.
- Cố định camera khi tối ưu độ sâu cho độ sâu tốt hơn (abs-rel 0,21 so với 0,23 khi tinh chỉnh tư thế).
Hướng gợi ý (đề xuất của EyeCode, không phải kết luận của bài báo)
- Định lượng mức đóng góp của mô hình mono-depth huấn luyện sẵn so với các thay đổi SLAM bằng cách hoán đổi chúng.
- Báo cáo kết quả từng chuỗi và độ biến thiên giữa các lần chạy trên Sintel, điều các bảng không cho thấy.
- Mở rộng thử nghiệm sang video dài hơn 600 khung và tiêu cự thay đổi.
Tài liệu tham khảo
- MegaSaM: Accurate, Fast, and Robust Structure and Motion from Casual Dynamic Videos (trang arXiv; đã đối chiếu Bảng 1-5 và phụ lục trong HTML v1 và v2)
- Bài báo MegaSaM (PDF arXiv)
- MegaSaM, trang open-access CVPR 2025
- Tài liệu bổ sung của MegaSaM (CVF)
- Trang dự án MegaSaM
- Kho mã MegaSaM
- Danh sách giải thưởng CVPR 2025