
Molmo and PixMo: Open Weights and Open Data for State-of-the-Art Vision-Language Models
Molmo và PixMo nghiên cứu cách xây dựng mô hình thị giác–ngôn ngữ với dữ liệu và trọng số mở. Các bộ dữ liệu caption, hỏi đáp và chỉ điểm do con người thu thập cung cấp nền tảng để phân tích lựa chọn mô hình và quy trình huấn luyện.
Bài báo công bố trọng số, dữ liệu và mã nguồn mở cho mô hình vision-language, và lập luận rằng thu thập dữ liệu người cẩn thận có thể thay thế việc chưng cất từ mô hình đóng. Bài đạt Best Paper Honorable Mention tại CVPR 2025. Bài viết này giải thích dữ liệu, mô hình và bằng chứng.
Tổng quan
Molmo là một họ mô hình AI nhìn và hiểu ảnh: nó có thể mô tả ảnh, trả lời câu hỏi về ảnh và chỉ ra vị trí của vật thể. Điểm khác biệt là cách xây dựng: nhóm tác giả tự thu thập dữ liệu huấn luyện từ con người thay vì nhờ một AI thương mại viết hộ. Trọng số, dữ liệu và mã nguồn đều được chia sẻ công khai.
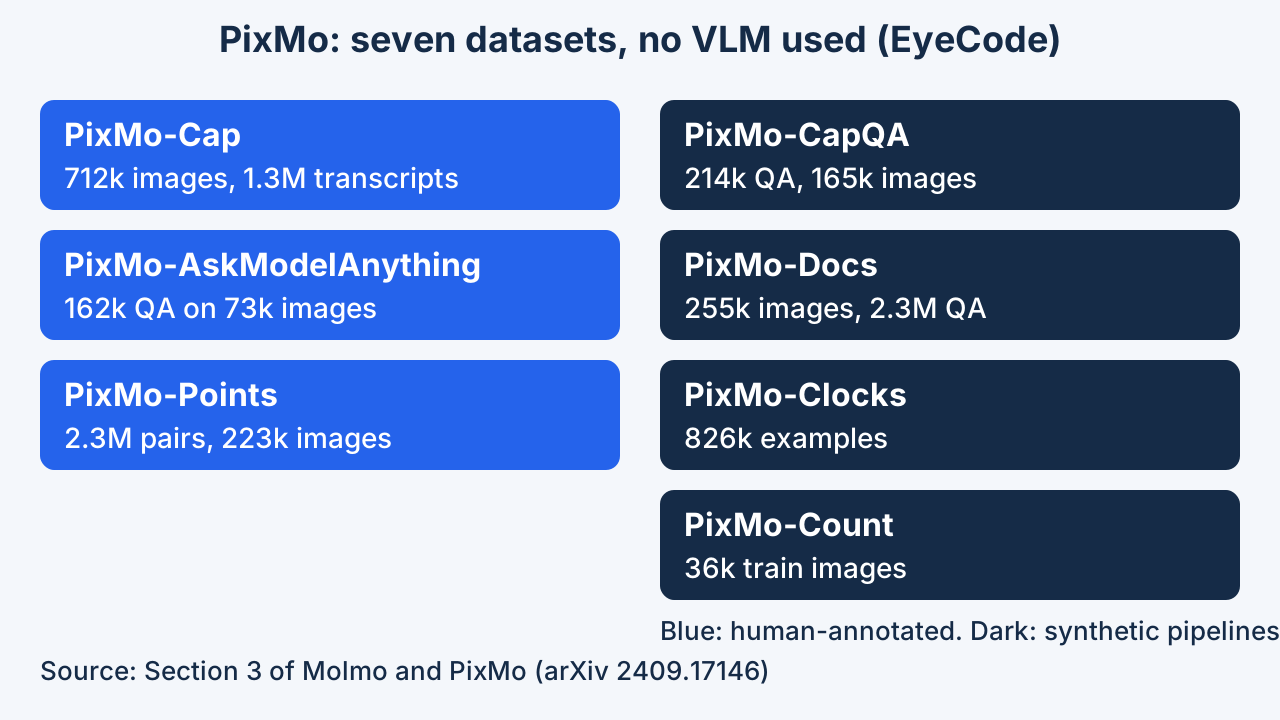
Theo trang giải thưởng chính thức của hội nghị, Molmo and PixMo đạt Best Paper Honorable Mention tại CVPR 2025. Bài báo trình bày hai thứ song song. Molmo là một họ mô hình vision-language (VLM) mở, ghép bộ mã hóa ảnh CLIP với một mô hình ngôn ngữ. PixMo là bộ bảy tập dữ liệu dùng để huấn luyện, ba tập do con người gán nhãn và bốn tập sinh tổng hợp mà không dùng bất kỳ VLM nào.
Luận điểm trung tâm nói về nguồn gốc dữ liệu: các VLM mở mạnh thường dựa vào dữ liệu do VLM đóng sinh ra, tức là bản chưng cất. Molmo tránh điều đó. Molmo-72B đạt trung bình cao nhất trên bộ 11 benchmark của nhóm và xếp thứ hai trong khảo sát ưa thích của con người, sau GPT-4o. Đây là so sánh do tác giả tự thực hiện vào cuối 2024.
Bài báo có hai đóng góp đan xen. Thứ nhất là PixMo: 712 nghìn ảnh có chú thích dày đặc, 162 nghìn cặp hỏi đáp trên 73 nghìn ảnh, 2,3 triệu nhãn chỉ điểm, cùng bốn tập tổng hợp cho tài liệu, đồng hồ, hỏi đáp từ caption và đếm. Thứ hai là Molmo: bốn mô hình (MolmoE-1B, Molmo-7B-O, Molmo-7B-D, Molmo-72B) huấn luyện bằng quy trình hai giai đoạn đơn giản.
Đánh giá dựa trên hai trụ cột: 11 benchmark học thuật, và một khảo sát con người với khoảng 870 người gán nhãn cùng hơn 325 nghìn lượt so sánh cặp, quy đổi sang điểm Elo bằng mô hình Bradley-Terry. Các ablation sau đó tách bạch lựa chọn dữ liệu và thiết kế nào thật sự quan trọng, điều có giá trị không kém bảng kết quả chính.
Bài toán nghiên cứu
Hãy hình dung bạn học nấu ăn chỉ bằng cách chép lại món của một đầu bếp nổi tiếng. Bạn có thể bắt chước giỏi nhưng không biết tự tạo công thức. Nhiều mô hình mở hiểu ảnh được huấn luyện theo kiểu chép đầu ra của mô hình đóng. Nhóm tác giả muốn có một công thức không phụ thuộc vào điều đó.
Bài báo xuất phát từ một khoảng trống. Các VLM tốt nhất (GPT-4o, Gemini 1.5, Claude 3.5 Sonnet) đều đóng. Các dự án mở đầu tiên như LLaVA công bố cả trọng số lẫn dữ liệu nhưng đã tụt lại. Các mô hình mở trọng số mới hơn hoặc dùng dữ liệu độc quyền, hoặc huấn luyện trên caption tổng hợp từ các hệ thống như GPT-4V, ví dụ ShareGPT4V. Tác giả cho rằng cộng đồng vì vậy thiếu kiến thức nền về cách xây dựng VLM mạnh từ đầu.
Kéo theo hai trở ngại. Người crowdsourcing gõ mô tả dài thường viết ngắn, hời hợt, và có thể dán văn bản từ mô hình thương mại. Dữ liệu định vị như bounding box hay mask thì thu chậm. Bài toán vì vậy vừa là câu hỏi về dữ liệu (thu nhãn chi tiết, đáng tin, rẻ) vừa về mô hình (dùng chúng ra sao).
Nói chính xác hơn, bài báo hỏi liệu trọng số mở cùng dữ liệu hoàn toàn không đến từ VLM có thể sánh với hệ thống độc quyền hay không. Ba nút thắt dữ liệu được chỉ ra. Caption dày đặc: người gõ bỏ sót phần lớn nội dung thị giác. Dữ liệu chỉ dẫn: câu trả lời tự do cần kiểm soát chất lượng. Định vị: box và mask đắt, hạn chế việc huấn luyện mô hình có thể hành động, chẳng hạn chỉ chỗ cần bấm hay vật cần cầm.
Vấn đề đánh giá cũng được coi là một phần của bài toán. Tác giả lưu ý số benchmark có thể lệch khoảng 10 phần trăm tùy prompt và cách xử lý, và nhiều chi tiết của mô hình khác không được công bố. Vì vậy họ ủng hộ đánh giá mở và bổ sung khảo sát ưa thích của con người bên cạnh benchmark.
Ý tưởng chính
Mẹo lớn là để con người nói thay vì gõ. Kể về một bức ảnh bằng lời trong hơn một phút sẽ ra nhiều chi tiết hơn nhiều so với viết. Mẹo thứ hai là dạy mô hình chỉ vào vật trong ảnh, và đếm bằng cách chỉ lần lượt từng vật.
Ba ý tưởng chống đỡ bài báo. Chú thích bằng giọng nói: người gán nhãn nói về một ảnh từ 60 đến 90 giây, hệ thống speech-to-text chép lại, rồi một LLM chỉ xử lý văn bản làm sạch hoặc gộp các bản chép. Bản ghi âm đồng thời là bằng chứng không dùng VLM. Caption thu được dài trung bình 196 từ, so với 11 từ của COCO.
Chỉ điểm vừa là dữ liệu vừa là đầu ra: mô hình sinh tọa độ điểm dạng văn bản thuần, và khi đếm thì chỉ vào từng đối tượng rồi nêu tổng, một dạng chain of thought. Cuối cùng là quy trình gọn hơn: không có giai đoạn chỉ huấn luyện connector, crop ảnh chồng lấn, và cách huấn luyện hiệu quả khi một ảnh có nhiều câu hỏi.
Tác giả nhấn mạnh chất lượng dữ liệu là quan trọng nhất, và các ablation ủng hộ điều đó: bỏ PixMo-Cap hoặc chỉ dùng dữ liệu học thuật làm Elo của con người giảm rõ rệt. Giọng nói hiệu quả vì chuyển chi phí từ gõ sang nói, gợi ra mô tả đầy đủ hơn trên mỗi phút công của người gán nhãn; bản ghi âm cũng giải quyết nguy cơ nhiễm dữ liệu từ mô hình độc quyền.
Chỉ điểm hấp dẫn vì một điểm gán nhanh hơn nhiều so với box hay mask, nên nhóm thu được 2,3 triệu cặp câu hỏi-điểm từ 223 nghìn ảnh. Bài báo cũng cho rằng chỉ điểm có thể trở thành giao diện cho agent như robot hay web agent, nhưng chỉ đánh giá nhẹ (ví dụ AndroidControl), chưa phải trong hệ thống triển khai thực.
Phương pháp
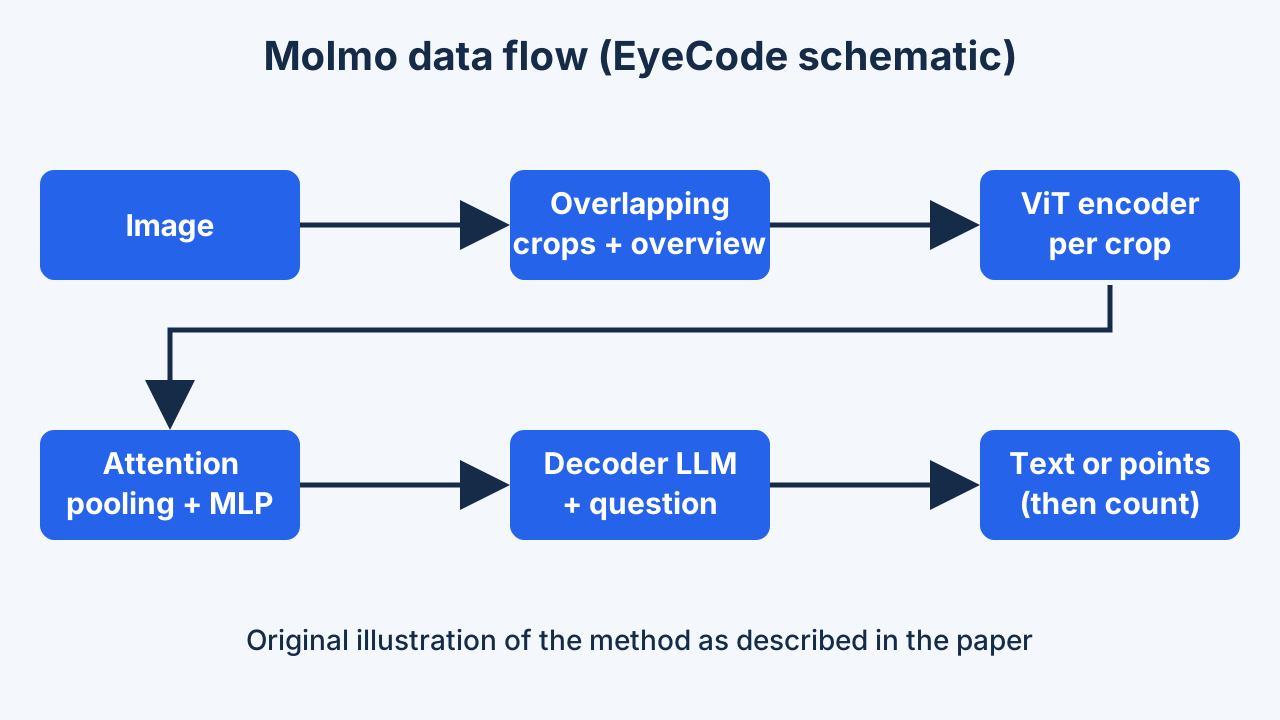
Molmo đọc ảnh giống như bạn xem một tấm bản đồ lớn: một bản tổng quan nhỏ cộng với nhiều mảnh phóng to. Mỗi mảnh được đổi thành một chuỗi token thị giác, mô hình ngôn ngữ đọc cùng câu hỏi của bạn rồi trả lời bằng lời hoặc bằng các điểm.
Kiến trúc có bốn phần. Bộ tiền xử lý tạo một bản toàn ảnh độ phân giải thấp và nhiều crop vuông độ phân giải cao. Bộ mã hóa CLIP ViT-L/14 ở 336 pixel xử lý từng crop. Connector gộp mỗi khối 2x2 patch bằng attention rồi chiếu qua MLP vào không gian của mô hình ngôn ngữ. Một LLM decoder-only sinh văn bản. LLM gồm OLMoE-1B-7B, OLMo-7B, Qwen2 7B và 72B.
Huấn luyện gồm hai giai đoạn. Pre-training: toàn bộ tham số học viết caption hoặc bản chép giọng nói của PixMo-Cap, có gợi ý độ dài trong 90 phần trăm trường hợp, bốn epoch. Fine-tuning: học từ hỗn hợp tập PixMo và tập học thuật công khai, với thẻ phong cách để câu trả lời ngắn kiểu benchmark chỉ xuất hiện khi được yêu cầu.
- Crop chồng lấn giúp patch ở rìa có ngữ cảnh lân cận.
- Dropout chỉ áp lên token văn bản khi pre-training, buộc mô hình dựa vào ảnh.
- Nhiều chú thích của cùng một ảnh dùng chung một lần mã hóa nhờ attention có mặt nạ, giảm thời gian huấn luyện hơn một nửa.
Chi tiết. ViT có 23 lớp, kích thước ẩn 1024; đặc trưng từ lớp thứ ba và thứ mười tính từ cuối được nối lại. Các crop chồng nhau 4 patch (56 pixel); với 12 crop, mỗi crop đóng góp lưới 12x12 token đã gộp, kèm token đặc biệt đánh dấu đầu, cuối và hết hàng. Một embedding học được đánh dấu vùng đệm để phân biệt viền đen có thật. Pre-training dùng batch 128 trong 22,3 nghìn bước; learning rate của connector là 2e-4 so với 6e-6 cho ViT, cắt gradient riêng từng module. Fine-tuning dùng batch 256 và 20 đến 32 nghìn bước tùy mô hình.
Chỉ điểm dùng định dạng văn bản giống HTML, tọa độ chuẩn hóa 0-100, sắp xếp từ trên xuống, trái sang phải và đánh số để chỉ số cuối chính là số đếm. Tỉ lệ lấy mẫu các tập fine-tuning theo căn bậc hai kích thước, có giảm trọng số thủ công cho các tập tổng hợp rất lớn. Chi phí huấn luyện được báo cáo bằng giờ H100: khoảng 4,2 nghìn cho pre-training và 8,3 nghìn cho fine-tuning với mô hình 72B.
PixMo-AskModelAnything thêm bước có con người trong vòng lặp: mô hình OCR và mô hình huấn luyện trên caption cung cấp ngữ cảnh cho một LLM chỉ văn bản, người gán nhãn chấp nhận hoặc yêu cầu sửa. PixMo-Docs nhờ LLM viết mã dựng 255 nghìn ảnh biểu đồ, bảng, tài liệu và sơ đồ, rồi sinh 2,3 triệu câu hỏi dựa trên mã đó. PixMo-CapQA có 214 nghìn cặp hỏi đáp trên 165 nghìn ảnh, do một LLM chỉ văn bản tạo từ caption. PixMo-Clocks có 826 nghìn ví dụ tổng hợp từ khoảng 50 kiểu thân đồng hồ và 160 nghìn mặt đồng hồ. PixMo-Count dùng bộ phát hiện chuẩn trên ảnh web, với tập validation và test 540 ảnh được người kiểm tra và 36 nghìn ảnh huấn luyện.
Thực nghiệm & kết quả
| Mô hình | DocVQA | MMMU | MathVista | CountBenchQA | PixMo-Count | 11-avg | Elo |
|---|---|---|---|---|---|---|---|
| GPT-4V | 87.2 | 63.1 | 58.1 | 69.9 | 45.0 | 71.1 | 1041 |
| GPT-4o-0513 | 92.8 | 69.1 | 63.8 | 87.9 | 59.6 | 78.5 | 1079 |
| Gemini 1.5 Pro | 93.1 | 62.2 | 63.9 | 85.8 | 64.3 | 78.3 | 1074 |
| Claude-3.5 Sonnet | 95.2 | 68.3 | 67.7 | 89.7 | 58.3 | 76.7 | 1069 |
| Qwen2-VL-72B | 96.5 | 64.5 | 70.5 | 80.4 | 55.7 | 79.4 | 1037 |
| Llama-3.2V-90B-Instruct | 90.1 | 60.3 | 57.3 | 78.5 | 58.5 | 74.5 | 1063 |
| LLaVA OneVision-72B (distilled) | 91.3 | 56.8 | 67.5 | 84.3 | 60.7 | 76.6 | 1051 |
| MolmoE-1B | 77.7 | 34.9 | 34.0 | 87.2 | 79.6 | 68.6 | 1032 |
| Molmo-7B-D | 92.2 | 45.3 | 51.6 | 88.5 | 84.8 | 77.3 | 1056 |
| Molmo-72B | 93.5 | 54.1 | 58.6 | 91.2 | 85.2 | 81.2 | 1077 |
| Bảng | Biến thể | cap F1 | 11-avg | Elo người |
|---|---|---|---|---|
| 2d | Một crop | 46.7 | 62.8 | n/a |
| 2d | Nhiều crop, không chồng lấn | 53.4 | 75.7 | n/a |
| 2d, 5 | Mặc định Molmo-7B-D (crop chồng lấn) | 54.1 | 76.9 | 1014 |
| 3c, 5 | Chỉ dữ liệu học thuật | n/a | 72.5 | 897 |
| 3c, 5 | Bỏ PixMo-AskModelAnything | n/a | 76.8 | 995 |
| 3c | Bỏ tác vụ chỉ điểm | n/a | 76.2 | n/a |
| 3a, 5 | Không có dữ liệu PixMo-Cap | n/a | 74.9 | 990 |
| 3b, 5 | Ảnh PixMo-Cap do GPT-4o viết caption | 52.9 | 77.5 | 1018 |
| Mô hình | Acc. chung | Acc. giờ | Acc. phút |
|---|---|---|---|
| GPT-4o-0513 | 2.7 | 14.2 | 8.6 |
| Claude-3.5 Sonnet | 6.6 | 22.3 | 17.5 |
| Qwen2-VL-72B | 9.1 | 24.9 | 18.4 |
| LLaVA OneVision-72B | 5.7 | 17.9 | 15.4 |
| MolmoE-1B | 65.8 | 77.9 | 74.1 |
| Molmo-7B-O | 64.2 | 76.3 | 73.8 |
| Molmo-7B-D | 68.2 | 78.6 | 76.0 |
| Molmo-72B | 65.6 | 77.1 | 73.7 |
| Mô hình chuyên biệt một tác vụ | 78.9 | 84.2 | 82.9 |
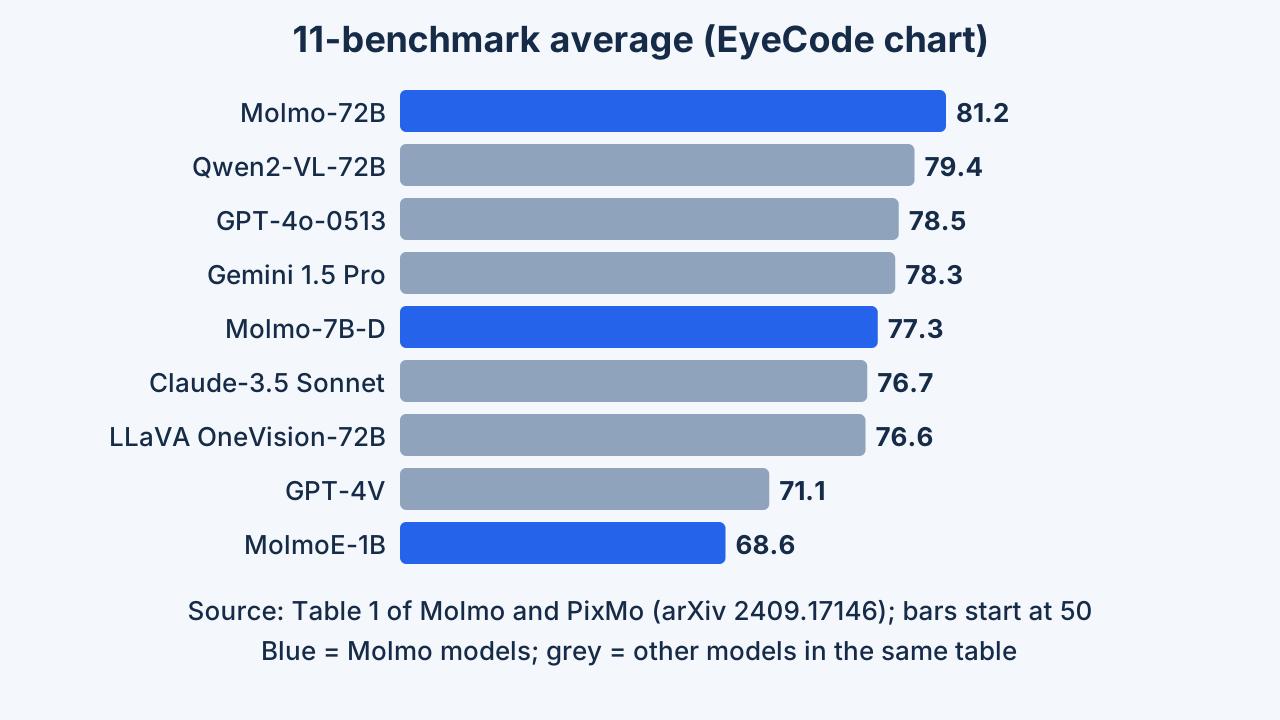
Trên một bộ lớn các bài kiểm tra hỏi đáp về ảnh, Molmo lớn nhất đạt điểm trung bình cao nhất trong số các mô hình được so sánh, dù không thắng ở mọi loại bài. Trong cuộc bình chọn của người thật, chỉ GPT-4o được ưa hơn. Molmo đặc biệt mạnh ở việc đếm và đọc đồng hồ kim, nơi hầu hết mô hình khác làm rất tệ.
Giao thức. Tác giả lấy trung bình 11 benchmark học thuật (gồm PixMo-Count mới của họ) thành một điểm, và chạy khảo sát con người với khoảng 870 người gán nhãn, hơn 325 nghìn lượt so sánh cặp, quy đổi thành Elo. Đối chứng gồm mô hình độc quyền (GPT-4o, Gemini 1.5, Claude), mở trọng số (Qwen2-VL, Llama 3.2V) và mở dữ liệu (LLaVA OneVision).
Kết quả chính (Bảng 1 phía trên). Molmo-72B có trung bình cao nhất, 81,2, và xếp thứ hai về Elo với 1077, sau GPT-4o (1079). Molmo-7B-D đạt 77,3 và 1056; MolmoE-1B đạt 68,6 và 1032, gần GPT-4V (71,1 và 1041).
Mạnh và yếu. Đếm là thắng lợi rõ nhất: 91,2 trên CountBenchQA và 85,2 trên PixMo-Count. Trên MMMU và MathVista, Molmo-72B được 54,1 và 58,6, thấp hơn Qwen2-VL-72B (64,5 và 70,5). Về đọc đồng hồ (Bảng 10 phụ lục, bảng thứ ba), Molmo-7B-D đạt 68,2, trong khi Claude-3.5 Sonnet được 6,6; mô hình chuyên biệt dẫn với 78,9.
Ablation (bảng thứ hai). Crop chồng lấn nâng trung bình từ 75,7 lên 76,9; mô hình chỉ dùng dữ liệu học thuật có Elo 897 so với 1014 mặc định.
Chi tiết giao thức. Molmo chạy với 36 crop trên benchmark học thuật (12 khi huấn luyện) nhưng với 12 crop và không có thẻ phong cách trong khảo sát con người; tác vụ đếm luôn dùng số crop như khi huấn luyện. Số liệu của mô hình khác lấy từ chính tác giả của chúng nếu có, rồi từ báo cáo hoặc bảng xếp hạng như OpenVLM, nếu không thì nhóm tự tính, nên prompt không hoàn toàn giống nhau. Bài báo tự lưu ý kết quả có thể lệch khoảng 10 phần trăm theo chi tiết đánh giá. Khảo sát con người dùng khoảng 15 nghìn cặp ảnh-prompt và phương pháp Bradley-Terry như Chatbot Arena.
Đọc Bảng 1. Bài báo nói kết quả học thuật và đánh giá con người phần lớn khớp nhau, ngoại lệ là Qwen2-VL, mạnh trên benchmark (79,4) nhưng xếp thấp hơn về Elo (1037, hạng 12). Molmo-72B dẫn hoặc ngang bằng ở RealWorldQA, VQA v2.0 và đếm, nhưng kém Qwen2-VL-72B ở ChartQA, DocVQA, InfoVQA và TextVQA. Bảng chia mô hình theo mức độ mở, và tác giả đánh dấu dao găm cho các mô hình chưng cất từ VLM độc quyền. Trên bảng xếp hạng vision độc lập của Chatbot Arena (tiếng Anh, ngày 13/11/2024), Molmo-72B được 1115, cao hơn Qwen2-VL-72B (1113) và mọi mô hình mở, nhưng thấp hơn GPT-4o-2024-05-13 (1213) và Claude 3.5 Sonnet (1187). Tác giả nói không biết cơ cấu câu hỏi và ngờ rằng thế mạnh đếm và mô tả của Molmo ít được thể hiện ở đó.
Ablation đếm (Bảng 4, CountBenchQA và PixMo-Count validation). Chỉ điểm rồi đếm cho 89,4 và 86,3; chỉ đếm cho 87,9 và 80,2; đếm rồi chỉ điểm 81,5 và 77,6; đếm các điểm bằng regular expression 88,4 và 85,4. Điểm không có thứ tự giảm còn 85,4 và 74,1. Với điểm ngẫu nhiên nhưng độ dài đúng là 85,9 và 76,3, điểm và độ dài đều ngẫu nhiên là 76,3 và 75,7. Tọa độ dạng văn bản thuần (89,4, 86,3) hơn token vị trí đặc biệt (85,8, 80,9). Tăng crop lúc test từ 12 lên 36 làm PixMo-Count tụt (85,2 xuống 73,9); một lượt fine-tune ngắn với 36 crop khôi phục lại (Bảng 12 phụ lục).
Các ablation khác (Bảng 2 và 3). Bộ mã hóa ảnh huấn luyện trên dữ liệu ảnh-văn bản quy mô web cho kết quả tương tự: CLIP 76,9, MetaCLIP 77,2 và SigLIP 77,1 trên 11-avg, còn DINOv2 chỉ dùng ảnh là 75,6. Một crop cho 62,8, nhiều crop 75,7, crop chồng lấn 76,9. Dropout chỉ trên văn bản khi pre-training đưa 11-avg từ 76,2 lên 76,9; bỏ giai đoạn chỉ huấn luyện connector không gây mất mát đáng kể. Tăng PixMo-Cap từ 0 đến 712 nghìn ảnh nâng 11-avg từ 74,9 lên 76,9. Caption của GPT-4o trên cùng bộ ảnh cho 77,5 tương đương, còn ShareGPT4V+o với 158 nghìn ảnh được 74,9. Bỏ PixMo-Docs hạ 11-avg xuống 75,8; bỏ PixMo-Clocks vẫn là 76,9.
Ablation con người (Bảng 5). Claude-3.5 Sonnet có Elo 1047 so với 1014 của Molmo-7B-D mặc định; GPT-4V 1010. Hòa rất thường gặp: khi gặp Claude, 45,5 phần trăm là hòa cả hai đều tốt, 14,1 phần trăm hòa cả hai đều tệ, Claude thắng 26,1 phần trăm và Molmo-7B-D thắng 14,3 phần trăm. Với mô hình chỉ dùng dữ liệu học thuật, Molmo-7B-D thắng 41,1 phần trăm và thua 8,4 phần trăm. Hộp nhãn đặc trên AI2D làm điểm của mô hình 72B tụt từ 96,3 xuống 86,4 (Bảng 14 phụ lục).
Tư liệu định tính trong bài chủ yếu là ví dụ dữ liệu (Hình 12 đến 22 phụ lục) và ví dụ chỉ điểm. Số liệu đọc đồng hồ (Bảng 10) cho thấy Molmo-72B thấp hơn các mô hình 7B-D và 1B-E (65,6 so với 68,2 và 65,8); tác giả cho rằng PixMo-Clocks chỉ chiếm 5,3 phần trăm hỗn hợp fine-tuning và mô hình 72B được huấn luyện ít bước hơn.
Hạn chế
Molmo không giỏi nhất mọi thứ. Nó yếu hơn ở các bài suy luận khó như toán và câu hỏi cấp chuyên gia, và các so sánh với mô hình khác không hoàn toàn công bằng tuyệt đối.
Do tác giả nêu
Bài báo không có mục hạn chế riêng; danh sách gom từ các phát biểu rải rác. Molmo tụt ở benchmark suy luận (MMMU, MathVista), có lẽ vì thiếu dữ liệu suy luận nâng cao. Năng lực chỉ văn bản giảm nhẹ so với LLM gốc. Về đọc đồng hồ, Molmo thua mô hình chuyên biệt. Số benchmark có thể lệch khoảng 10 phần trăm theo chi tiết đánh giá.
Phân tích của EyeCode (diễn giải biên tập)
So sánh do chính tác giả chạy với mô hình cuối 2024, nên thứ hạng có thể đã đổi. Molmo-72B dùng Qwen2 72B (mở trọng số, không mở dữ liệu), nên chỉ một số biến thể mở hoàn toàn. Elo của tác giả và Chatbot Arena không thống nhất về hạng. Lời hứa về agent và robot dựa trên một thử nghiệm nhẹ (AndroidControl).
Do tác giả nêu
Nêu trong thân bài và phụ lục: benchmark suy luận tụt lại; năng lực chỉ văn bản giảm nhẹ (Qwen2 trong Molmo-7B-D mất một phần kiến thức sau fine-tuning đa phương thức); đọc đồng hồ thua mô hình chuyên biệt và Molmo-72B thấp hơn các mô hình nhỏ hơn; không huấn luyện với câu hỏi có hơn 40 đối tượng vì độ dài chuỗi; đếm và caption suy giảm khi số crop lúc test khác lúc huấn luyện (khắc phục bằng fine-tune ngắn ở độ phân giải cao); các câu hỏi "how many" trong PixMo-AskModelAnything không có dữ liệu chỉ điểm nên mô hình đôi khi không chỉ điểm, và tác giả thêm chỉ dẫn không chỉ điểm; chỉ điểm làm lời giải thích kém tin cậy hơn nên bị khóa sau thẻ phong cách; mô hình 72B cần learning rate thấp hơn; và tác giả cho rằng khác biệt với Chatbot Arena có thể đến từ loại câu hỏi chưa biết.
Phân tích của EyeCode (diễn giải biên tập)
Bảng 1 trộn số do tác giả tính với số lấy từ báo cáo và bảng xếp hạng, nên chênh lệch nhỏ ở trung bình 11 benchmark cần đọc thận trọng; trung bình đó còn gồm PixMo-Count do chính tác giả tạo ra. Khảo sát con người dùng bộ prompt và người gán nhãn riêng, hòa thường xuyên, nên chênh Elo nhỏ là bằng chứng yếu. Ablation chỉ chạy trên Molmo-7B-D, và bài báo tự nhận cap F1 với mức tăng benchmark không phải lúc nào cũng đi cùng nhau. Việc dùng chỉ điểm cho agent và robot là một lập luận, chưa phải kết quả đã kiểm chứng.
Điểm cần nhớ
Dữ liệu tốt, được thu thập cẩn thận, có thể quan trọng không kém một mô hình khổng lồ. Để người nói thay vì gõ, và dạy mô hình chỉ điểm, là hai ý tưởng đơn giản nhưng mạnh.
- Chất lượng dữ liệu quyết định: chỉ dữ liệu học thuật cho Elo 897 so với 1014 mặc định.
- Chú thích bằng giọng nói cho caption 196 từ và bản ghi âm làm bằng chứng không chưng cất.
- Chỉ điểm giúp đếm tốt hơn: point-then-count được 89,4 và 86,3, chỉ đếm được 87,9 và 80,2.
- Molmo-72B dẫn đầu trung bình 11 benchmark và xếp thứ hai về Elo, nhưng tụt ở bài suy luận.
- Giải thưởng chính thức là Best Paper Honorable Mention tại CVPR 2025; nhận định benchmark là của tác giả.
Hướng gợi ý (đề xuất của EyeCode, không phải kết luận của bài báo)
- Chạy lại so sánh ưa thích của con người và đếm với các mô hình mở mới hơn.
- Thử dùng chỉ điểm làm định dạng đầu ra cho tác vụ giao diện hoặc robot và đo trực tiếp.
- Đổi phương thức rẻ tiền (nói thay vì gõ) nâng chất lượng chú thích và cho bằng chứng về nguồn gốc.
- Bỏ giai đoạn chỉ huấn luyện connector khi dữ liệu pre-training dày và sạch; dùng crop chồng lấn và chuỗi nhiều chú thích với attention có mặt nạ.
- Đếm bằng chỉ điểm có thứ tự là một dạng chain of thought, lợi ích phụ thuộc vị trí điểm đúng (Bảng 4).
- Đánh giá bằng cả benchmark và ưa thích của con người, vì chúng không khớp với Qwen2-VL và với Chatbot Arena.
- Chưng cất từ mô hình đóng làm nhiễu các tuyên bố về công thức mở; caption GPT-4o trên cùng bộ ảnh ngang caption của người ở 11-avg (77,5 so với 76,9), nên cả chất lượng nguồn caption lẫn độ đa dạng ảnh đều quan trọng.
Hướng gợi ý (đề xuất của EyeCode, không phải kết luận của bài báo)
- Kiểm tra bao nhiêu phần lợi ích của PixMo-Cap đến từ độ chi tiết so với độ đa dạng ảnh.
- Lặp lại ablation đếm ở quy mô 72B, vì bài báo chỉ báo cáo ở 7B.
- Thêm ảnh đồng hồ thật vào PixMo-Clocks, đúng như chính tác giả đề xuất.