
VGGT: Visual Geometry Grounded Transformer
VGGT dùng một mạng feed-forward để suy ra camera, độ sâu, point map và quỹ đạo điểm từ một hoặc nhiều ảnh. Kiến trúc chung nghiên cứu cách học các thuộc tính hình học 3D liên quan trong cùng mô hình thay vì những bộ giải riêng biệt.
VGGT thay chuỗi bước hình học lặp bằng một transformer duy nhất cho dựng hình 3D từ ảnh. Bài này tóm tắt bài toán, phương pháp, số liệu đã đối chiếu với bài báo và các giới hạn tác giả nêu.
Tổng quan
VGGT là một mạng nơ-ron nhìn vài tấm ảnh của cùng một cảnh và, chỉ trong một lượt, cho biết mỗi ảnh được chụp từ đâu, vật ở xa hay gần và các điểm 3D nằm ở đâu. Trước đây việc này cần những thuật toán lặp đi lặp lại, chậm và dễ hỏng. Trang giải thưởng chính thức của CVPR 2025 liệt kê bài báo này là Best Paper.
VGGT (Visual Geometry Grounded Transformer) là mạng feed-forward nhận từ một đến hàng trăm ảnh của một cảnh và dự đoán trực tiếp tham số camera (nội tại và ngoại tại), bản đồ độ sâu, point map 3D và track điểm. Tác giả cho biết mạng chạy dưới một giây với tập ảnh nhỏ và thường vượt các phương pháp dựa trên tối ưu hóa mà không cần hậu xử lý. Nhóm tác giả gồm Jianyuan Wang, Minghao Chen, Nikita Karaev, Andrea Vedaldi, Christian Rupprecht và David Novotny (Visual Geometry Group, Oxford và Meta AI).
Đóng góp chính theo bài báo: (1) một transformer lớn dự đoán mọi đại lượng 3D quan trọng cùng lúc; (2) kết quả dùng trực tiếp được và thường tốt hơn các phương pháp có hậu xử lý chậm; (3) khi kết hợp thêm bundle adjustment (BA) thì còn tốt hơn nữa; (4) backbone đã huấn luyện có thể dùng lại cho tracking điểm động và novel view synthesis. Việc bài báo nằm trong danh sách Best Paper là ghi nhận chính thức của hội nghị; các nhận xét về ý nghĩa của nó là diễn giải biên tập của EyeCode.
Bài báo đề xuất một transformer khoảng 1,2 tỷ tham số với rất ít thiên kiến quy nạp riêng cho 3D (chỉ có luân phiên attention trong khung và toàn cục), huấn luyện đa nhiệm trên khoảng 17 nguồn dữ liệu có chú thích 3D. Một lượt forward trả về camera, depth, point map và đặc trưng tracking dày cho mọi khung. Hai tuyên bố thực nghiệm chính: (i) đầu ra feed-forward vượt các baseline tối ưu hóa và theo cặp như DUSt3R, MASt3R trên các benchmark được báo cáo; (ii) thêm BA lên trên còn cải thiện tiếp. Tác giả cũng đặt VGGT như một backbone dùng lại được (tracking động, novel view synthesis). Cần phân biệt: giải Best Paper là ghi nhận chính thức, còn các đánh giá khác ở đây là biên tập.
Bài toán nghiên cứu
Muốn dựng lại cảnh 3D từ ảnh, người ta thường phải ước lượng vị trí chụp, ghép điểm giữa các ảnh rồi tinh chỉnh đi tinh chỉnh lại. Quy trình này chậm và dễ lỗi. Bài báo hỏi: một mạng lớn có thể làm tất cả trong một bước không?
Structure-from-motion (SfM) cổ điển gồm nhiều giai đoạn: ghép ảnh, tam giác hóa và bundle adjustment. Học máy đã cải thiện từng thành phần, và VGGSfM kết hợp học với BA khả vi, nhưng hình học vẫn đóng vai trò lớn nên hệ thống phức tạp và tốn tính toán. DUSt3R và MASt3R dự đoán point map cho một cặp ảnh nhưng chỉ xử lý hai ảnh một lúc và cần hậu xử lý (global alignment) để ghép nhiều ảnh.
Công thức bài toán: đầu vào là N ảnh RGB của cùng một cảnh (N từ một đến hàng trăm). Với mỗi ảnh, mạng xuất camera (9 số), bản đồ depth, point map trong hệ tọa độ của camera đầu tiên và lưới đặc trưng dùng cho tracking. Ảnh đầu tiên là khung tham chiếu; thứ tự các ảnh còn lại là tùy ý. Khó ở chỗ mạng phải suy ra đồng thời hình học cảnh và vị trí các góc nhìn mà không được cho trước camera.
Camera là vector 9 chiều: quaternion xoay (4), tịnh tiến (3) và trường nhìn (2), điểm chính cố định ở tâm ảnh. Point map cho tọa độ 3D từng pixel trong hệ của camera đầu tiên nên bất biến theo góc nhìn. Kiến trúc là permutation-equivariant với mọi khung trừ khung đầu. Các đại lượng dư thừa: camera suy ra được từ point map (ví dụ qua PnP) và depth suy ra được từ point map cùng camera; tác giả vẫn huấn luyện dự đoán tất cả vì cách này tăng độ chính xác (mục 4.5). Khác DUSt3R, dự đoán không bị chuẩn hóa lúc suy luận: ground truth được chia cho khoảng cách trung bình từ các điểm 3D tới gốc, và mạng phải tự học thang đo đó từ dữ liệu.
Ý tưởng chính
Thay vì thiết kế nhiều bước hình học phức tạp, tác giả dùng một transformer khá bình thường, để các ảnh "nhìn nhau" và dạy bằng thật nhiều dữ liệu. Mạng luân phiên: lúc xem riêng từng ảnh, lúc xem tất cả ảnh cùng nhau. Ví dụ đời thường: bạn xem từng ảnh để nhận ra chi tiết, rồi đặt tất cả lên bàn để so sánh, lặp lại nhiều vòng.
Ý tưởng cốt lõi là một transformer lớn gần như chuẩn với một lựa chọn cấu trúc: alternating attention (AA), luân phiên self-attention trong từng khung và self-attention toàn cục trên token của mọi khung. Mô hình học đồng thời nhiều đại lượng 3D liên quan (camera, depth, point map, track) trên nhiều bộ dữ liệu công khai. Tác giả báo cáo rằng học chung làm tăng độ chính xác, và rằng lúc suy luận, point map dựng từ depth cộng camera cho kết quả tốt hơn head point map chuyên dụng.
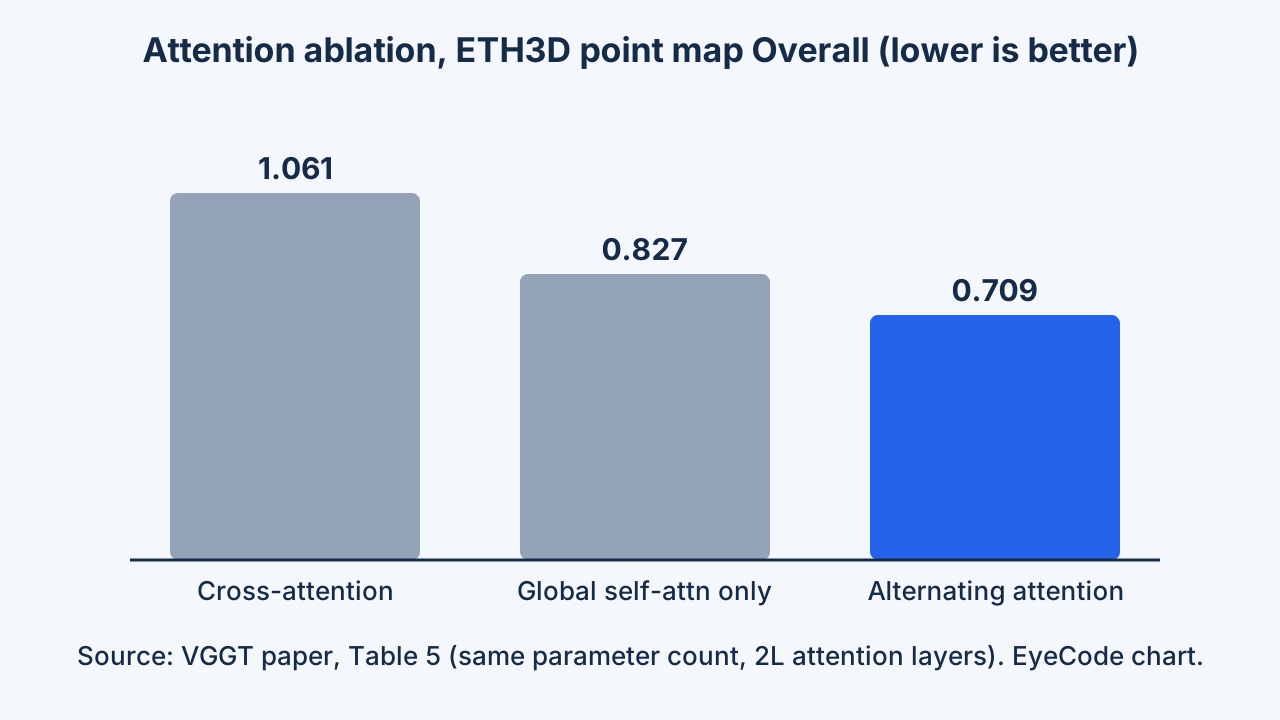
AA cân bằng giữa việc tích hợp thông tin giữa các ảnh và việc chuẩn hóa activation trong từng ảnh. Trong ablation (Bảng 5, ETH3D, cùng số tham số với 2L lớp attention) lỗi point map Overall là 0,709 với AA, 0,827 với global self-attention thuần và 1,061 với cross-attention; tác giả cũng viết rằng các thử nghiệm sơ bộ khác cho thấy cross-attention thường kém self-attention. Bảng 6: bỏ camera loss tăng Overall lên 0,834, bỏ track loss lên 0,790, bỏ depth loss lên 0,727, vậy camera loss đóng góp rõ nhất còn depth chỉ cải thiện nhẹ. Cần nhớ đây là ablation trên một benchmark (ETH3D, 10 khung mỗi cảnh).
Phương pháp
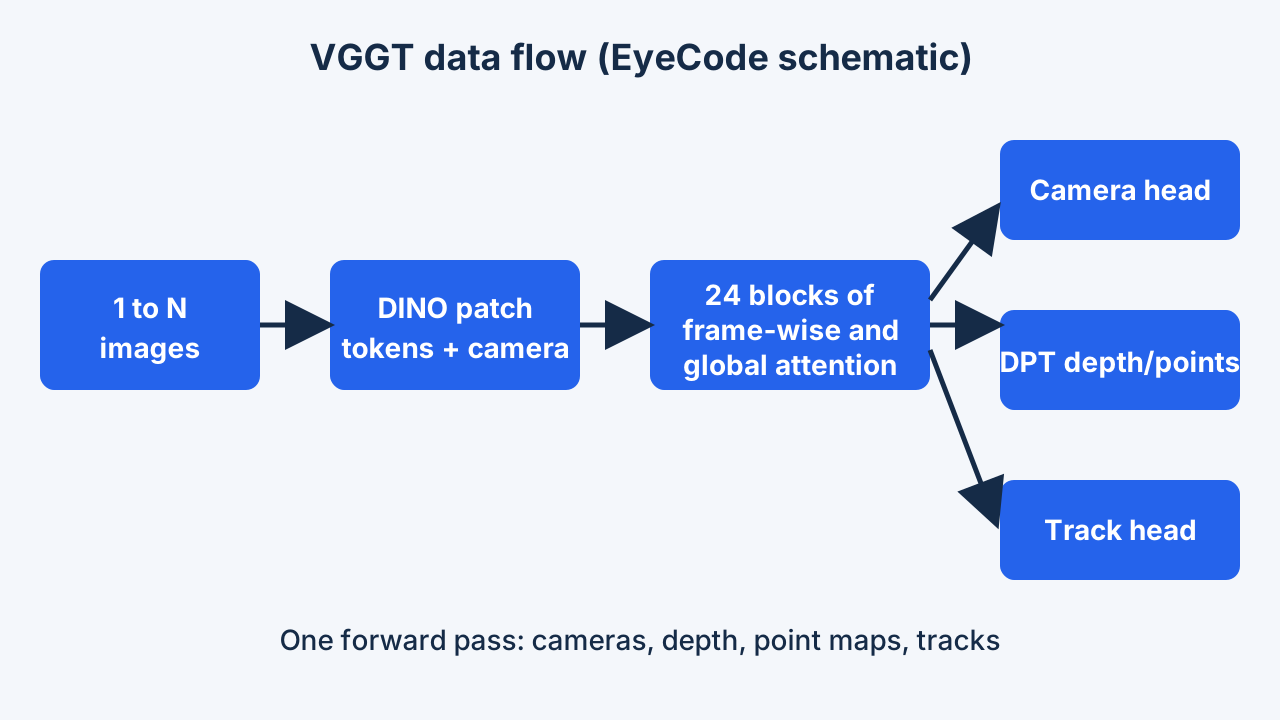
Mỗi ảnh được cắt thành các mảnh nhỏ (token). Mạng xử lý token của tất cả ảnh qua nhiều khối attention. Cuối cùng có ba đầu ra: một cho camera, một cho depth và điểm 3D, một cho theo dõi điểm giữa các ảnh.
Pipeline: (1) mỗi ảnh được chia thành patch 14×14 và biến thành token bằng DINOv2; (2) mỗi khung thêm một camera token và bốn register token, riêng khung đầu dùng bộ token học được khác để đánh dấu khung tham chiếu; (3) 24 khối, mỗi khối có một lớp attention trong khung và một lớp attention toàn cục; (4) head camera (bốn lớp self-attention và một lớp tuyến tính) dự đoán camera, head DPT dự đoán depth, point map và độ bất định, và head tracking dựa trên CoTracker2 dự đoán vị trí của một điểm truy vấn ở các ảnh khác.
Dữ liệu huấn luyện gồm khoảng 17 nguồn (Co3Dv2, BlendMVS, DL3DV, MegaDepth, Kubric, WildRGB, ScanNet, HyperSim, Mapillary, Habitat, Replica, MVS-Synth, PointOdyssey, Virtual KITTI, hai bộ Aria và một bộ tài sản tổng hợp do nghệ sĩ tạo). Tổng loss là camera + depth + point map + 0,05 lần loss track.
Mỗi lớp attention có chiều 1024 và 16 head (theo ViT-L của DINOv2), dùng QKNorm và LayerScale khởi tạo 0,01; tổng cộng khoảng 1,2 tỷ tham số. Đặc trưng từ khối 4, 11, 17, 23 được đưa vào DPT. Loss camera là Huber. Loss depth theo DUSt3R: phần dư nhân với bản đồ bất định (aleatoric) cộng số hạng so khớp gradient và số hạng log bất định; loss point map định nghĩa tương tự. Loss track là khoảng cách tới điểm tương ứng thật, kèm BCE cho visibility như CoTracker2. Công thức: $\mathcal{L}=\mathcal{L}_{camera}+\mathcal{L}_{depth}+\mathcal{L}_{pmap}+0.05\,\mathcal{L}_{track}$.
Huấn luyện: AdamW, 160K bước, learning rate đỉnh 0,0002, cosine với 8K bước warmup; mỗi batch gồm 48 khung lấy từ một cảnh ngẫu nhiên với 2–24 khung mỗi cảnh; cạnh dài 518 px, tỷ lệ khung ngẫu nhiên 0,33–1,0, cắt cạnh ngắn 168–518 px, color augmentation độc lập từng khung, gradient clipping 1,0, bfloat16 và gradient checkpointing; 64 GPU A100 trong chín ngày. Biến thể BA khởi tạo từ depth và point map đã dự đoán nên không cần bước tam giác hóa của VGGSfM. BA khả vi lúc huấn luyện làm mỗi bước chậm khoảng 4 lần (theo bản HTML arXiv v1), nên tác giả không dùng.
Thực nghiệm & kết quả
| Phương pháp | Re10K AUC@30 | CO3Dv2 AUC@30 | Thời gian |
|---|---|---|---|
| DUSt3R | 67.7 | 76.7 | ~7 s |
| MASt3R | 76.4 | 81.8 | ~9 s |
| VGGSfM v2 | 78.9 | 83.4 | ~10 s |
| MV-DUSt3R ‡ | 71.3 | 69.5 | ~0.6 s |
| CUT3R ‡ | 75.3 | 82.8 | ~0.6 s |
| FLARE ‡ | 78.8 | 83.3 | ~0.5 s |
| Fast3R ‡ | 72.7 | 82.5 | ~0.2 s |
| VGGT (feed-forward) | 85.3 | 88.2 | ~0.2 s |
| VGGT (with BA) | 93.5 | 91.8 | ~1.8 s |
| Phương pháp | GT camera | Acc. | Comp. | Overall |
|---|---|---|---|---|
| PatchmatchNet | yes | 0.427 | 0.377 | 0.417 |
| MASt3R | yes | 0.403 | 0.344 | 0.374 |
| GeoMVSNet | yes | 0.331 | 0.259 | 0.295 |
| DUSt3R | no | 2.677 | 0.805 | 1.741 |
| VGGT | no | 0.389 | 0.374 | 0.382 |
| Phương pháp | TTO | AUC@3° | AUC@5° | AUC@10° | Thời gian |
|---|---|---|---|---|---|
| PixSfM (SP + SG) | yes | 45.19 | 57.22 | 70.47 | >20 s |
| DFSfM (LoFTR) | yes | 46.55 | 58.74 | 72.19 | >10 s |
| DUSt3R | yes | 13.46 | 21.24 | 35.62 | ~7 s |
| MASt3R | yes | 30.25 | 46.79 | 57.42 | ~9 s |
| VGGSfM | yes | 45.23 | 58.89 | 73.92 | ~6 s |
| VGGSfMv2 | yes | 59.32 | 67.78 | 76.82 | ~10 s |
| VGGT | no | 39.23 | 52.74 | 71.26 | 0.2 s |
| VGGT + BA | yes | 66.37 | 75.16 | 84.91 | 1.8 s |
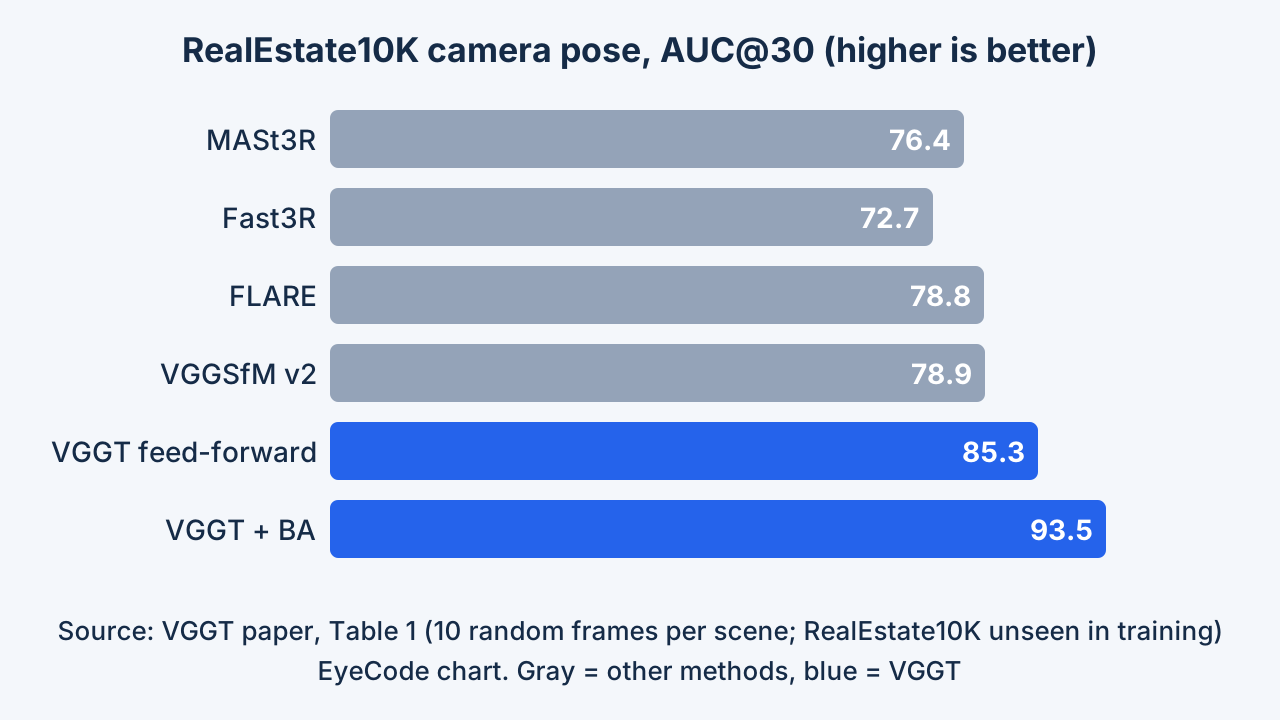
Trên nhiều bài kiểm tra, VGGT ước lượng vị trí camera chính xác hơn các phương pháp trước và nhanh hơn rất nhiều, khoảng 0,2 giây. Thêm một bước tinh chỉnh BA thì kết quả còn tốt hơn nữa. Chi tiết xem các bảng bên dưới.
Giao thức: pose camera được đo bằng AUC@30 (diện tích dưới đường cong độ chính xác góc, kết hợp sai số xoay và tịnh tiến) trên RealEstate10K và CO3Dv2, với 10 khung ngẫu nhiên mỗi cảnh. Mô hình không được huấn luyện trên RealEstate10K. Baseline gồm DUSt3R, MASt3R, VGGSfM v2 và các công trình đồng thời (MV-DUSt3R, CUT3R, FLARE, Fast3R). Bảng 1 cho thấy VGGT feed-forward đạt 85,3 và 88,2, thêm BA đạt 93,5 và 91,8. Theo tác giả, khoảng cách rõ hơn trên RealEstate10K và BA vẫn còn mang lại cải thiện.
Các kết quả khác: trên DTU, Overall giảm từ 1,741 (DUSt3R) xuống 0,382 mà không cần camera thật. Trên ETH3D (10 khung, căn chỉnh bằng Umeyama), Overall là 0,709 với head point map và 0,677 khi dựng từ depth cộng camera, so với 0,826 của MASt3R và 1,005 của DUSt3R. So khớp hai ảnh trên ScanNet-1500: AUC@5 là 33,9 so với 31,8 của Roma. Trong tracking động, gắn đặc trưng VGGT vào CoTracker nâng AJ trên Kinetics từ 49,6 lên 57,2. Về tốc độ, Bảng 9 báo 0,14 giây cho 10 khung và 1,04 giây cho 50 khung trên một GPU H100.
Định tính: tác giả chọn ví dụ tranh sơn dầu, hai ảnh không chồng lấn và họa tiết lặp, nơi DUSt3R bị méo hoặc thất bại.
IMC (Bảng 10, phụ lục C): VGGT feed-forward đạt AUC@10 71,26, kém VGGSfMv2 (76,82) nhưng nhanh hơn nhiều (0,2 so với khoảng 10 giây); ở ngưỡng chặt AUC@3 chỉ 39,23 so với 59,32 của VGGSfMv2. Với BA, VGGT đạt 66,37 và 84,91. Lưu ý tác giả dùng cùng phần chia MegaDepth như DUSt3R/MASt3R cho so sánh này, và loại các cảnh ScanNet liên quan khỏi huấn luyện khi đánh giá ScanNet-1500. Trên DTU, MASt3R và GeoMVSNet dùng camera thật (0,374 và 0,295 Overall), còn VGGT và DUSt3R thì không.
Novel view synthesis (Bảng 7, GSO): VGGT-NVS dùng 4 ảnh đầu vào, không cần camera đầu vào, đạt PSNR 30,41, SSIM 0,949, LPIPS 0,033, so với LVSM 31,71 / 0,957 / 0,027 (có camera đầu vào, huấn luyện trên Objaverse); VGGT-NVS dùng bộ dữ liệu nội bộ chỉ khoảng 20% cỡ Objaverse và ảnh 224 thay vì 256, nên không phải so sánh ngang bằng. Tracking (Bảng 8): đặc trưng VGGT thay backbone của CoTracker2 rồi tinh chỉnh toàn bộ trên Kubric; trên Kinetics AJ 57,2 so với 49,6, trên RGB-S 72,1 so với 67,4 và trên DAVIS 64,7 so với 61,8. Đây là đo đặc trưng VGGT làm backbone, không phải tracking head của VGGT đứng riêng.
Bộ nhớ và thời gian (Bảng 9, H100, ảnh 336×518, chỉ backbone): 1 khung 0,04 s / 1,88 GB; 100 khung 3,12 s / 21,15 GB; 200 khung 8,75 s / 40,63 GB. Head camera chiếm khoảng 5% thời gian và 2% bộ nhớ của backbone; head DPT dùng trung bình 0,03 s và 0,2 GB mỗi khung. Về thiết kế, tác giả viết rằng patchify bằng DINOv2 tốt hơn conv 14×14 và huấn luyện ổn định hơn, và chuẩn hóa dự đoán là không cần thiết, nhưng văn bản không đưa số liệu cho hai nhận định này.
Hạn chế
Mạng chưa xử lý tốt ảnh mắt cá hay ảnh toàn cảnh, xoay camera quá mạnh, hoặc cảnh biến dạng nhiều như vải đang chuyển động. Chạy với rất nhiều ảnh cũng tốn nhiều bộ nhớ.
Do tác giả nêu
Phần Discussions của bài báo nêu: mô hình hiện không hỗ trợ ảnh fisheye hoặc panorama; chất lượng giảm khi ảnh đầu vào xoay cực đoan; mô hình chịu được chuyển động phi cứng nhỏ nhưng thất bại khi biến dạng phi cứng lớn. Tác giả cho rằng có thể khắc phục bằng tinh chỉnh trên dữ liệu phù hợp. Họ cũng thừa nhận global self-attention tốn bộ nhớ khi có nhiều token và gợi ý dùng kỹ thuật như tensor parallelism.
Phân tích của EyeCode (diễn giải biên tập)
Bộ nhớ đạt 40,63 GB ở 200 khung cho thấy giới hạn thực tế với ảnh rất nhiều. Ở ngưỡng góc chặt trên IMC, bản feed-forward còn kém bản có BA, nên BA vẫn có chỗ đứng khi cần độ chính xác cao.
Do tác giả nêu
Ba giới hạn trên (fisheye/panorama, xoay cực đoan, phi cứng lớn) là toàn bộ danh sách trong phần Discussions; tác giả nói chúng có thể giải quyết bằng tinh chỉnh. Họ thừa nhận chi phí bộ nhớ của global attention và nhắc rằng head DPT dự đoán độc lập từng khung nên có thể suy luận từng khung khi thiếu bộ nhớ. Họ cũng ghi rằng BA khả vi hứa hẹn nhưng chưa dùng vì chi phí huấn luyện.
Phân tích của EyeCode (diễn giải biên tập)
Một số lưu ý khi đọc kết quả. Trên IMC, VGGT feed-forward kém VGGSfMv2 (AUC@3 39,23 so với 59,32; AUC@10 71,26 so với 76,82), tức tuyên bố "vượt mọi thứ" cần đọc kèm điều kiện đánh giá. Một số so sánh không ngang bằng (DTU dùng camera thật cho các phương pháp khác; NVS dùng ít dữ liệu hơn LVSM). Huấn luyện cần dữ liệu có chú thích 3D lớn và nhiều tính toán (64 A100 trong chín ngày), nên tái lập đầy đủ tốn kém. Bài báo không báo cáo ablation theo số khung đầu vào trong các bảng chính.
Điểm cần nhớ
Một lượt chạy của mạng có thể thay nhiều bước hình học chậm nếu được huấn luyện với đủ dữ liệu. Nó vẫn còn giới hạn với ảnh đặc biệt và cảnh biến dạng mạnh.
- Một mạng feed-forward dự đoán camera, depth, point map và track trong một lượt.
- Alternating attention và học đa nhiệm là hai lựa chọn có ablation hỗ trợ (Bảng 5 và 6).
- Trên RealEstate10K và CO3Dv2, AUC@30 đạt 85,3 và 88,2 trong khoảng 0,2 giây; thêm BA lên 93,5 và 91,8.
- BA vẫn cải thiện thêm, nhất là ở ngưỡng góc chặt.
- Giới hạn: fisheye, panorama, xoay cực đoan, biến dạng phi cứng lớn và bộ nhớ.
Hướng gợi ý (đề xuất của EyeCode, không phải kết luận của bài báo)
- Thử kết hợp VGGT với BA nhẹ trên dữ liệu riêng của bạn và so với COLMAP về thời gian và lỗi.
- Kiến trúc ít thiên kiến quy nạp cộng dữ liệu đa dạng và nhiều tín hiệu giám sát có thể cạnh tranh với pipeline hình học cổ điển.
- Dự đoán dư thừa (depth, camera, point map) có ích khi huấn luyện, và ghép depth với camera lúc suy luận tốt hơn head point map.
- Khi đánh giá, nhớ điều kiện: baseline đồng thời như Fast3R chạy khoảng 0,2 s còn CUT3R và FLARE khoảng 0,5–0,6 s trong Bảng 1, nên lợi thế chủ yếu là độ chính xác chứ không hẳn tốc độ.
- NVS và tracking đều dùng VGGT làm backbone tinh chỉnh, không phải sản phẩm của mô hình gốc đứng riêng.
Hướng gợi ý (đề xuất của EyeCode, không phải kết luận của bài báo)
- Tích hợp attention tiết kiệm bộ nhớ hoặc parallelism để mở rộng tới hàng nghìn ảnh.
- Thử tinh chỉnh cho camera méo hoặc cảnh động như tác giả gợi ý, với kiểm tra nhỏ trước.